Kur 75 drejtues kontrolluan regjistrimet më të reja të njësive të tyre, 47% kishin mesatarisht të paktën një gabim kritik, dhe më pak se 3% e rezultateve e arritën pragun që vunë vetë. Vlerësimet e kostos shkojnë nga 12,9 milionë dollarë në vit për organizatë sipas Gartner deri në 3,1 trilionë dollarë për SHBA-në sipas IBM, asnjëra me metodë të dukshme. Në AI, 92% e 53 praktikuesve të intervistuar kishin hasur një kaskadë të dhënash, dhe grupet e testimit të disa benchmark-eve të përdorura gjerësisht kanë mesatarisht të paktën 3,3% etiketa të gabuara.
Management Review · Botimi mujor · Tetor 2026 · Nr. 30
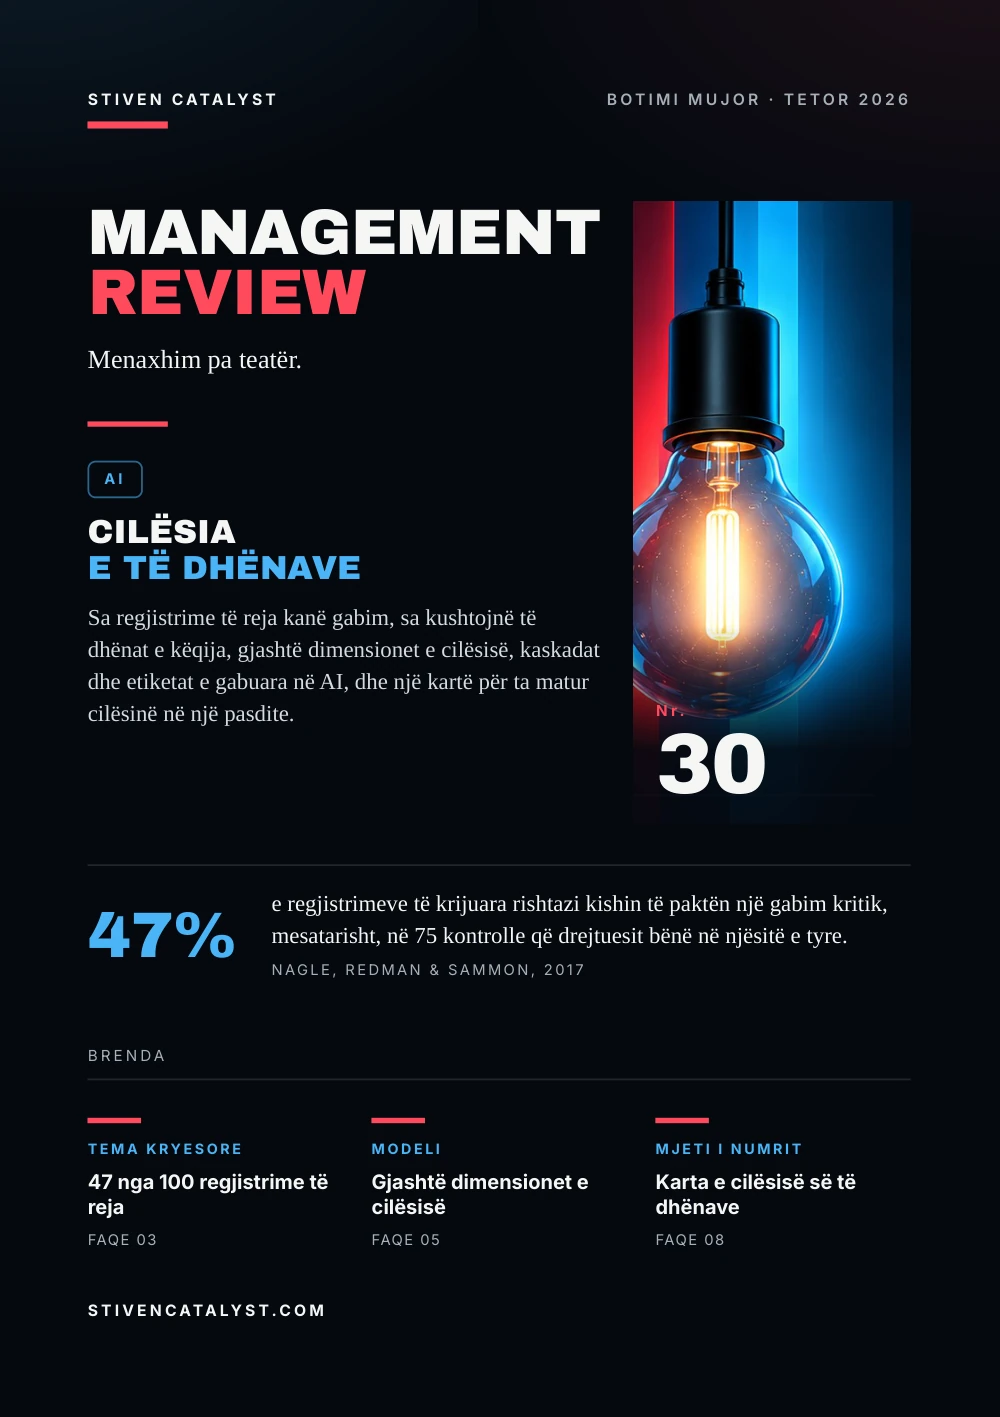
Cilësia e të dhënave
Sa regjistrime të reja kanë gabim, sa kushtojnë të dhënat e këqija, gjashtë dimensionet e cilësisë, kaskadat dhe etiketat e gabuara në AI, dhe një kartë për ta matur cilësinë në një pasdite.
- Nr.
- 30
- Faqe
- 10
- Burimet
- 8
- Tema
- AI
Stiven CatalystBotimi mujor · Tetor 2026
ManagementReview
Menaxhim pa teatër.
AI
Cilësiae të dhënave
Sa regjistrime të reja kanë gabim, sa kushtojnë të dhënat e këqija, gjashtë dimensionet e cilësisë, kaskadat dhe etiketat e gabuara në AI, dhe një kartë për ta matur cilësinë në një pasdite.

Nr.30
47%
e regjistrimeve të krijuara rishtazi kishin të paktën një gabim kritik, mesatarisht, në 75 kontrolle që drejtuesit bënë në njësitë e tyre.Nagle, Redman & Sammon, 2017
stivencatalyst.com
Nr. 30 · AI
Në këtë numër
Çdo raport, KPI dhe model AI është aq i mirë sa regjistrimet mbi të cilat mbështetet. Ky numër pyet sa prej këtyre regjistrimeve janë të gabuara, sa kushton kjo, dhe si mund ta zbulojë një ekip në një pasdite.
- 03Tema kryesore47 nga 100 regjistrime të reja
- 04ShifratSa kushtojnë të dhënat e këqija
- 05ModeliGjashtë dimensionet e cilësisë
- 06Çfarë thotë kërkimiTë gjithë duan punën me modelin
- 07Si matetMatja e së premtes pasdite
- 08Mjeti i numritKarta e cilësisë së të dhënave
- 09BurimetBurimet dhe metoda
Si lexohet ky numër
Shifra
Çdo shifër ka burimin dhe vitin poshtë faqes së vet.
Leximi ynë
Ku flet redaksia dhe jo kërkimi, shkruhet qartë.
Praktika
Hapat dhe karta janë propozime për t'u provuar, jo rezultate kërkimi.
Tema kryesore
47 nga 100regjistrime të re ja
Gjatë dy vjetëve, 75 drejtues bënë të njëjtën provë në njësitë e tyre: morën 100 regjistrimet e fundit që kishin krijuar ose përdorur ekipet e tyre dhe numëruan ato pa asnjë gabim kritik, pra gabim që ndikon në punë.
e regjistrimeve të krijuara rishtazi kishin mesatarisht të paktën një gabim kritik.
Të pyetur sa të mira duhej të ishin të dhënat, asnjë drejtues nuk quajti të pranueshëm një rezultat nën nëntëdhjetat e larta, dhe më pak se 3% e rezultateve e arritën këtë prag. Rezultatet shkonin nga 0 deri në 99, dhe autorët nuk gjetën dallime domethënëse mes industrive.
Leximi ynë
Prova merr një pasdite dhe nuk kërkon softuer. Pjesa e vështirë është të shikosh regjistrimet që bëri vetë ekipi yt.
Burimi: Tadhg Nagle, Thomas C. Redman & David Sammon, Harvard Business Review, 2017
75 matje të drejtuesve në njësitë e tyre: mostër e vogël, jo përfaqësuese. Pragu ishte i vetë drejtuesve, dhe 3% janë matje, jo kompani.
Shifrat
Sa kusht ojnëtë dhënat e këqija
Koston e plotë të të dhënave të këqija nuk e ka matur askush. Ka vlerësime dhe rregulla empirike, që duhen lexuar bashkë me kufizimet e tyre.
12,9 mln $në vit: kostoja mesatare e cilësisë së dobët të të dhënave për organizatë sipas Gartner (2021)
50%e kohës së punonjësve të dijes humbet në fabrikat e fshehura të të dhënave, vlerëson Redman
44%e firmave gjermane që e shqyrtuan AI-në, por nuk e përdorin, përmendin disponueshmërinë ose cilësinë e të dhënave (2025)
Kostoja e 100 njësive pune me 1 dollar secila, sipas rregullit të dhjetës të Redman-it ($)
Redman i quan fabrika të fshehura të të dhënave hapat shtesë që shton një ekip për të përballuar gabimet e bëra më lart në zinxhir, dhe rregulli i tij i dhjetës thotë se të dhënat me gabime bëjnë një njësi pune dhjetë herë më të shtrenjtë. Të dyja janë vlerësime të tij, jo matje. Shifra më e njohur, 3,1 trilionë dollarë në vit për SHBA-në në 2016, ishte e IBM; Redman shkroi më vonë se mund të jetë gabim me një trilion dollarë, në njërin ose në tjetrin drejtim.
Burimet: Manasi Sakpal, Gartner, 2021; Thomas C. Redman, Harvard Business Review, 2016 (përmes SAP Community, 2023); Statistisches Bundesamt (Destatis), 2025; Tadhg Nagle, Thomas C. Redman & David Sammon, Harvard Business Review, 2017
Vlerësime, jo matje, që nuk mblidhen dhe nuk krahasohen. Gartner nuk tregon si e nxori mesataren; shifra gjermane është arsye që e deklarojnë vetë firmat, jo matje e cilësisë së të dhënave.
Modeli
Gjashtë dimensione te cilësisë
Në 2013, një grup pune i DAMA UK, shoqatës për menaxhimin e të dhënave, emërtoi gjashtë dimensione kryesore për të vlerësuar cilësinë e të dhënave. Qeveria britanike i mori në kornizën e saj të cilësisë së të dhënave në 2020.
01
Plotësia
nuk mungon asgjë që duhet të jetë
02
Veçantia
asnjë regjistrim nuk del dy herë
03
Aktualiteti
ndryshimet në burim shfaqen shpejt aty ku përdoren të dhënat
04
Vlefshmëria
vlerat përputhen me formatin dhe rregullat e rëna dakord
05
Saktësia
të dhënat pasqyrojnë realitetin
06
Konsistenca
të dhënat përputhen mes burimeve, gjë që nuk i bën të sakta
Për AI-në, Gartner vë një provë tjetër: të dhënat janë gati për AI kur përfaqësojnë rastin e përdorimit, bashkë me rregullsitë, gabimet dhe vlerat e skajshme që i duhen modelit. Në një anketë të Gartner të 2024 me 1.203 drejtues të menaxhimit të të dhënave, 63% thanë se organizata e tyre nuk i ka, ose s'është e sigurt se i ka, praktikat e duhura të të dhënave për AI.
Leximi ynë
E pastër nuk do të thotë e përshtatshme për përdorim. Pyetja është gjithmonë: mjaftueshëm e mirë për çfarë?
Burimet: DAMA UK Working Group, 2013 (përmes UK Government Data Quality Framework, 2020); Gartner, 2025
Përkufizimet ndjekin përmbledhjet e dokumentit të DAMA UK; DAMA-DMBOK dhe burime të tjera japin lista më të gjata. 63% është vetëdeklarim.
Më shumë te esejaGabimet humbasin mes departamenteve
Çfarë thotë kërkimi
Të gjithë duanpunën me modelin
Nithya Sambasivan dhe kolegët e saj te Google intervistuan 53 praktikues që ndërtojnë AI për përdorime me rrezik të lartë në Indi, në Afrikën Lindore e Perëndimore dhe në SHBA. 92% kishin hasur të paktën një kaskadë të dhënash: një problem të dhënash që grumbullohet dhe dëmton rezultatet më poshtë në zinxhir.
Etiketa të gabuara në grupet e testimit të benchmark-eve të përdorura gjerësisht (%)
Curtis Northcutt, Anish Athalye dhe Jonas Mueller gjetën mesatarisht të paktën 3,3% etiketa të gabuara në grupet e testimit të dhjetë grupeve të përdorura gjerësisht me imazhe, tekst dhe audio. Gabime të tilla mund ta përmbysin renditjen e modeleve: te ImageNet, ResNet-18 më i vogël del më mirë se ResNet-50 nëse pjesa e shembujve të testimit me etiketë fillimisht të gabuar rritet me vetëm 6%.
Leximi ynë
Një model gjykohet kundrejt të dhënave. Nëse të dhënat janë të gabuara, i gabuar është edhe gjykimi.
Burimet: Nithya Sambasivan et al., ACM CHI, 2021; Curtis G. Northcutt, Anish Athalye & Jonas Mueller, NeurIPS Datasets and Benchmarks, 2021
Intervista me 53 veta, jo anketë përfaqësuese; grupe publike testimi, jo të dhëna kompanish. Versionet e punimit japin 3,3% ose 3,4%.
Si matet
Matja e së premtespasdite
Metoda e Nagle-it, Redman-it dhe Sammon-it nuk kërkon softuer: një ekip, një pasdite dhe 100 regjistrimet e fundit që ka krijuar ose ka përdorur.
Merr 100 regjistrimet e fundit
ato që njësia jote krijoi ose përdori së fundi
Zgjidh 10–15 fushat më të rëndësishme
ato nga të cilat varet hapi tjetër
Shëno çdo gabim të dukshëm
regjistrim pas regjistrimi, me njerëz që i njohin të dhënat
Numëro regjistrimet pa gabim
ky numër, nga 0 deri në 100, është rezultati
Shembull hipotetik, 100 porosi klientësh
- Gabimet
- adresë e gabuar te 9, pa numër telefoni te 14, sasi e gabuar te 5; 4 porosi kanë dy gabime
- Rezultati
- 24 porosi kanë gabim, 76 janë të pastra: rezultati 76
- Rregulli i 10
- puna prej 100 $ kushton 76 + 24 × 10 = 316 $
Porositë dhe gabimet janë të shpikura.
Burimi: Tadhg Nagle, Thomas C. Redman & David Sammon, Harvard Business Review, 2017
Hapat ndjekin Nagle, Redman & Sammon (2017); rregulli i dhjetës është rregull empirik i Redman-it; shembulli është i redaksisë.
Mjeti i numrit
Kar ta e cilësisësë të dhënave
Një kartë për çdo kontroll, një herë në muaj. Numëro gabimet sipas fushës, pastaj renditi: zakonisht pak fusha mbajnë shumicën e tyre.
01Regjistrimet e kontrolluaracilat 100, nga cili hap, në cilën datë
02Fushat kritike10–15 fushat nga të cilat varet hapi tjetër
03Gabimet sipas fushësmungon, e gabuar, e dyfishtë apo e vjetruar
04Rezultatiregjistrime pa gabim nga 100
05Ku nisin gabimethapi ose sistemi ku krijohen më shumë
06Ndreqe në burimnjë ndryshim, kush, deri kur; mate sërish muajin tjetër
Burimet: Tadhg Nagle, Thomas C. Redman & David Sammon, Harvard Business Review, 2017; DAMA UK Working Group, 2013 (përmes UK Government Data Quality Framework, 2020)
Praktikë e propozuar nga redaksia, sipas matjes së së premtes pasdite (2017) dhe dimensioneve të DAMA UK (2013).
Hape mjetin: Pareto 80/20stivencatalyst.com/sq/tools/pareto/
Burimet dhe metoda
Çdo shifërka një burim.
Shifrat e këtij numri vijnë nga burimet më poshtë. Viti tregon sa e re është secila.
- Only 3% of Companies’ Data Meets Basic Quality StandardsTadhg Nagle, Thomas C. Redman & David Sammon, Harvard Business Review, 2017https://hbr.org/2017/09/only-3-of-companies-data-meets-basic-quality-standards
- Gründe gegen die Nutzung von Technologien der künstlichen Intelligenz nach BeschäftigtengrößenklassenStatistisches Bundesamt (Destatis), 2025https://www.destatis.de/DE/Themen/Branchen-Unternehmen/Unternehmen/IKT-in-Unternehmen-IKT-Branche/Tabellen/ikti-gegen-nutzung-kuenstliche-intelligenz.html
- “Everyone wants to do the model work, not the data work”: Data Cascades in High-Stakes AINithya Sambasivan et al., ACM CHI, 2021https://research.google/pubs/everyone-wants-to-do-the-model-work-not-the-data-work-data-cascades-in-high-stakes-ai/
- Pervasive Label Errors in Test Sets Destabilize Machine Learning BenchmarksCurtis G. Northcutt, Anish Athalye & Jonas Mueller, NeurIPS Datasets and Benchmarks, 2021https://arxiv.org/abs/2103.14749
- Bad Data Costs the U.S. $3 Trillion Per YearThomas C. Redman, Harvard Business Review, 2016 · përmes SAP Community, 2023https://hbr.org/2016/09/bad-data-costs-the-u-s-3-trillion-per-year
- Lack of AI-Ready Data Puts AI Projects at RiskGartner, 2025https://www.gartner.com/en/newsroom/press-releases/2025-02-26-lack-of-ai-ready-data-puts-ai-projects-at-risk
- How to Improve Your Data QualityManasi Sakpal, Gartner, 2021https://www.gartner.com/smarterwithgartner/how-to-improve-your-data-quality
- The Six Primary Dimensions for Data Quality AssessmentDAMA UK Working Group, 2013 · përmes UK Government Data Quality Framework, 2020
Metoda editoriale
Çdo shifër u kontrollua për vitin, botuesin dhe çfarë mat saktësisht. Kur faqja e botuesit nuk hapej, shifra u kontrollua te përmbledhje të pavarura dhe shënohet me “përmes”. Interpretimi i redaksisë shënohet “Leximi ynë”. Shifrat që nuk u konfirmuan nuk janë në numër.
ManagementReview
Menaxhim pa teatër.
Çdo numër, një pyetje e menaxhimit, e kontrolluar me kërkimet më të mira.
Të gjithë numrat
stivencatalyst.com/sq/magazine/management-review.html
Management Review · Nr. 30 · Tetor 2026 · Stiven Catalyst
Kliko ose rrëshqit mbi faqe për ta kthyer. Punojnë edhe shigjetat e tastierës.
Management Review · Nr. 30
Shifrat e numrit
Grafikët e faqeve të printuara, me burimet e tyre.
47% e regjistrimeve të krijuara rishtazi kishin mesatarisht të paktën një gabim kritik.
Burimi: Tadhg Nagle, Thomas C. Redman & David Sammon, Harvard Business Review, 2017
Burimi: Tadhg Nagle, Thomas C. Redman & David Sammon, Harvard Business Review, 2017
Burimi: Curtis G. Northcutt, Anish Athalye & Jonas Mueller, NeurIPS Datasets and Benchmarks, 2021
I gjithë teksti Lexoje numrin si tekst Për ekran të vogël, për kërkim ose për lexues ekrani. Të njëjtat fjalë, pa dizajnin e faqeve.
Në këtë numër
Çdo raport, KPI dhe model AI është aq i mirë sa regjistrimet mbi të cilat mbështetet. Ky numër pyet sa prej këtyre regjistrimeve janë të gabuara, sa kushton kjo, dhe si mund ta zbulojë një ekip në një pasdite.
Kur 75 drejtues kontrolluan regjistrimet më të reja të njësive të tyre, 47% kishin mesatarisht të paktën një gabim kritik, dhe më pak se 3% e rezultateve e arritën pragun që vunë vetë. Vlerësimet e kostos shkojnë nga 12,9 milionë dollarë në vit për organizatë sipas Gartner deri në 3,1 trilionë dollarë për SHBA-në sipas IBM, asnjëra me metodë të dukshme. Në AI, 92% e 53 praktikuesve të intervistuar kishin hasur një kaskadë të dhënash, dhe grupet e testimit të disa benchmark-eve të përdorura gjerësisht kanë mesatarisht të paktën 3,3% etiketa të gabuara.
Stiven Janaqi, Redaktor
Tema kryesore
47 nga 100 regjistrime të re ja
Gjatë dy vjetëve, 75 drejtues bënë të njëjtën provë në njësitë e tyre: morën 100 regjistrimet e fundit që kishin krijuar ose përdorur ekipet e tyre dhe numëruan ato pa asnjë gabim kritik, pra gabim që ndikon në punë.
47% e regjistrimeve të krijuara rishtazi kishin mesatarisht të paktën një gabim kritik.
Të pyetur sa të mira duhej të ishin të dhënat, asnjë drejtues nuk quajti të pranueshëm një rezultat nën nëntëdhjetat e larta, dhe më pak se 3% e rezultateve e arritën këtë prag. Rezultatet shkonin nga 0 deri në 99, dhe autorët nuk gjetën dallime domethënëse mes industrive.
Leximi ynë
Prova merr një pasdite dhe nuk kërkon softuer. Pjesa e vështirë është të shikosh regjistrimet që bëri vetë ekipi yt.
75 matje të drejtuesve në njësitë e tyre: mostër e vogël, jo përfaqësuese. Pragu ishte i vetë drejtuesve, dhe 3% janë matje, jo kompani.
Burimi: Tadhg Nagle, Thomas C. Redman & David Sammon, Harvard Business Review, 2017
Shifrat
Sa kusht ojnë të dhënat e këqija
Koston e plotë të të dhënave të këqija nuk e ka matur askush. Ka vlerësime dhe rregulla empirike, që duhen lexuar bashkë me kufizimet e tyre.
- 12,9 mln $ në vit: kostoja mesatare e cilësisë së dobët të të dhënave për organizatë sipas Gartner (2021)
- 50% e kohës së punonjësve të dijes humbet në fabrikat e fshehura të të dhënave, vlerëson Redman
- 44% e firmave gjermane që e shqyrtuan AI-në, por nuk e përdorin, përmendin disponueshmërinë ose cilësinë e të dhënave (2025)
Kostoja e 100 njësive pune me 1 dollar secila, sipas rregullit të dhjetës të Redman-it ($): Të gjitha të pastra 100, 11 regjistrime me gabim 199.
Redman i quan fabrika të fshehura të të dhënave hapat shtesë që shton një ekip për të përballuar gabimet e bëra më lart në zinxhir, dhe rregulli i tij i dhjetës thotë se të dhënat me gabime bëjnë një njësi pune dhjetë herë më të shtrenjtë. Të dyja janë vlerësime të tij, jo matje. Shifra më e njohur, 3,1 trilionë dollarë në vit për SHBA-në në 2016, ishte e IBM; Redman shkroi më vonë se mund të jetë gabim me një trilion dollarë, në njërin ose në tjetrin drejtim.
Vlerësime, jo matje, që nuk mblidhen dhe nuk krahasohen. Gartner nuk tregon si e nxori mesataren; shifra gjermane është arsye që e deklarojnë vetë firmat, jo matje e cilësisë së të dhënave.
Burimet: Manasi Sakpal, Gartner, 2021; Thomas C. Redman, Harvard Business Review, 2016 (përmes SAP Community, 2023); Statistisches Bundesamt (Destatis), 2025; Tadhg Nagle, Thomas C. Redman & David Sammon, Harvard Business Review, 2017
Modeli
Gjashtë dimensione t e cilësisë
Në 2013, një grup pune i DAMA UK, shoqatës për menaxhimin e të dhënave, emërtoi gjashtë dimensione kryesore për të vlerësuar cilësinë e të dhënave. Qeveria britanike i mori në kornizën e saj të cilësisë së të dhënave në 2020.
- Plotësia. nuk mungon asgjë që duhet të jetë
- Veçantia. asnjë regjistrim nuk del dy herë
- Aktualit
e ti. ndryshimet në burim shfaqen shpejt aty ku përdoren të dhënat - Vlefshmëria. vlerat përputhen me formatin dhe rregullat e rëna dakord
- Saktësia. të dhënat pasqyrojnë realitetin
- Konsistenca. të dhënat përputhen mes burimeve, gjë që nuk i bën të sakta
Për AI-në, Gartner vë një provë tjetër: të dhënat janë gati për AI kur përfaqësojnë rastin e përdorimit, bashkë me rregullsitë, gabimet dhe vlerat e skajshme që i duhen modelit. Në një anketë të Gartner të 2024 me 1.203 drejtues të menaxhimit të të dhënave, 63% thanë se organizata e tyre nuk i ka, ose s'është e sigurt se i ka, praktikat e duhura të të dhënave për AI.
Leximi ynë
E pastër nuk do të thotë e përshtatshme për përdorim. Pyetja është gjithmonë: mjaftueshëm e mirë për çfarë?
Përkufizimet ndjekin përmbledhjet e dokumentit të DAMA UK; DAMA-DMBOK dhe burime të tjera japin lista më të gjata. 63% është vetëdeklarim.
Burimet: DAMA UK Working Group, 2013 (përmes UK Government Data Quality Framework, 2020); Gartner, 2025
Më shumë te eseja: Gabimet humbasin mes departamenteve
Çfarë thotë kërkimi
Të gjithë duan punën me modelin
Nithya Sambasivan dhe kolegët e saj te Google intervistuan 53 praktikues që ndërtojnë AI për përdorime me rrezik të lartë në Indi, në Afrikën Lindore e Perëndimore dhe në SHBA. 92% kishin hasur të paktën një kaskadë të dhënash: një problem të dhënash që grumbullohet dhe dëmton rezultatet më poshtë në zinxhir.
Etiketa të gabuara në grupet e testimit të benchmark-eve të përdorura gjerësisht (%): MNIST 0,15, Mesatarja e 10 grupeve 3,3, ImageNet, grupi i validimit 6, QuickDraw 10,12.
Curtis Northcutt, Anish Athalye dhe Jonas Mueller gjetën mesatarisht të paktën 3,3% etiketa të gabuara në grupet e testimit të dhjetë grupeve të përdorura gjerësisht me imazhe, tekst dhe audio. Gabime të tilla mund ta përmbysin renditjen e modeleve: te ImageNet, ResNet-18 më i vogël del më mirë se ResNet-50 nëse pjesa e shembujve të testimit me etiketë fillimisht të gabuar rritet me vetëm 6%.
Leximi ynë
Një model gjykohet kundrejt të dhënave. Nëse të dhënat janë të gabuara, i gabuar është edhe gjykimi.
Intervista me 53 veta, jo anketë përfaqësuese; grupe publike testimi, jo të dhëna kompanish. Versionet e punimit japin 3,3% ose 3,4%.
Burimet: Nithya Sambasivan et al., ACM CHI, 2021; Curtis G. Northcutt, Anish Athalye & Jonas Mueller, NeurIPS Datasets and Benchmarks, 2021
Si matet
Matja e së premtes pasdite
Metoda e Nagle-it, Redman-it dhe Sammon-it nuk kërkon softuer: një ekip, një pasdite dhe 100 regjistrimet e fundit që ka krijuar ose ka përdorur.
- Merr 100 regjistrim
e t e fundit. ato që njësia jote krijoi ose përdori së fundi - Zgjidh 10–15 fushat më të rëndësishme. ato nga të cilat varet hapi tjetër
- Shëno çdo gabim të dukshëm. regjistrim pas regjistrimi, me njerëz që i njohin të dhënat
- Numëro regjistrim
e t pa gabim. ky numër, nga 0 deri në 100, është rezultati
Shembull hipote tik, 100 porosi klientësh
- Gabim
e t: adresë e gabuar te 9, pa numër telefoni te 14, sasi e gabuar te 5; 4 porosi kanë dy gabime - R
e zultati: 24 porosi kanë gabim, 76 janë të pastra: rezultati 76 - Rregulli i 10: puna prej 100 $ kushton 76 + 24 × 10 = 316 $
Porositë dhe gabimet janë të shpikura.
Hapat ndjekin Nagle, Redman & Sammon (2017); rregulli i dhjetës është rregull empirik i Redman-it; shembulli është i redaksisë.
Burimi: Tadhg Nagle, Thomas C. Redman & David Sammon, Harvard Business Review, 2017
Mjeti i numrit
Kar ta e cilësisë së të dhënave
Një kartë për çdo kontroll, një herë në muaj. Numëro gabimet sipas fushës, pastaj renditi: zakonisht pak fusha mbajnë shumicën e tyre.
- Regjistrim
e t e kontrolluara cilat 100, nga cili hap, në cilën datë - Fushat kritike 10–15 fushat nga të cilat varet hapi tjetër
- Gabim
e t sipas fushës mungon, e gabuar, e dyfishtë apo e vjetruar - R
e zultati regjistrime pa gabim nga 100 - Ku nisin gabim
e t hapi ose sistemi ku krijohen më shumë - Ndreqe në burim një ndryshim, kush, deri kur; mate sërish muajin tjetër
Praktikë e propozuar nga redaksia, sipas matjes së së premtes pasdite (2017) dhe dimensioneve të DAMA UK (2013).
Burimet: Tadhg Nagle, Thomas C. Redman & David Sammon, Harvard Business Review, 2017; DAMA UK Working Group, 2013 (përmes UK Government Data Quality Framework, 2020)
Hape mjetin: Pareto 80/20
Burimet dhe metoda
Çdo shifër ka një burim.
Shifrat e këtij numri vijnë nga burimet më poshtë. Viti tregon sa e re është secila.
- Tadhg Nagle, Thomas C. Redman & David Sammon, Harvard Business Review, “Only 3% of Companies’ Data Meets Basic Quality Standards”, 2017. https://hbr.org/2017/09/only-3-of-companies-data-meets-basic-quality-standards
- Statistisches Bundesamt (Destatis), “Gründe gegen die Nutzung von Technologien der künstlichen Intelligenz nach Beschäftigtengrößenklassen”, 2025. https://www.destatis.de/DE/Themen/Branchen-Unternehmen/Unternehmen/IKT-in-Unternehmen-IKT-Branche/Tabellen/ikti-gegen-nutzung-kuenstliche-intelligenz.html
- Nithya Sambasivan et al., ACM CHI, ““Everyone wants to do the model work, not the data work”: Data Cascades in High-Stakes AI”, 2021. https://research.google/pubs/everyone-wants-to-do-the-model-work-not-the-data-work-data-cascades-in-high-stakes-ai/
- Curtis G. Northcutt, Anish Athalye & Jonas Mueller, NeurIPS Datasets and Benchmarks, “Pervasive Label Errors in Test Sets Destabilize Machine Learning Benchmarks”, 2021. https://arxiv.org/abs/2103.14749
- Thomas C. Redman, Harvard Business Review, “Bad Data Costs the U.S. $3 Trillion Per Year”, 2016 (përmes SAP Community, 2023). https://hbr.org/2016/09/bad-data-costs-the-u-s-3-trillion-per-year
- Gartner, “Lack of AI-Ready Data Puts AI Projects at Risk”, 2025. https://www.gartner.com/en/newsroom/press-releases/2025-02-26-lack-of-ai-ready-data-puts-ai-projects-at-risk
- Manasi Sakpal, Gartner, “How to Improve Your Data Quality”, 2021. https://www.gartner.com/smarterwithgartner/how-to-improve-your-data-quality
- DAMA UK Working Group, “The Six Primary Dimensions for Data Quality Assessment”, 2013 (përmes UK Government Data Quality Framework, 2020).
Me t oda edit oriale
Çdo shifër u kontrollua për vitin, botuesin dhe çfarë mat saktësisht. Kur faqja e botuesit nuk hapej, shifra u kontrollua te përmbledhje të pavarura dhe shënohet me “përmes”. Interpretimi i redaksisë shënohet “Leximi ynë”. Shifrat që nuk u konfirmuan nuk janë në numër.
Management Review · Botimi mujor