Als 75 Führungskräfte die neuesten Datensätze ihrer eigenen Einheiten prüften, hatten im Schnitt 47 % mindestens einen kritischen Fehler, und weniger als 3 % der Werte erreichten die selbst gesetzte Schwelle. Kostenschätzungen reichen von Gartners 12,9 Millionen Dollar pro Jahr und Organisation bis zu IBMs 3,1 Billionen Dollar für die USA, keine mit erkennbarer Methode. In der KI hatten 92 % von 53 befragten Fachleuten eine Datenkaskade erlebt, und die Testdaten verbreiteter Benchmarks enthalten im Schnitt mindestens 3,3 % falsche Labels.
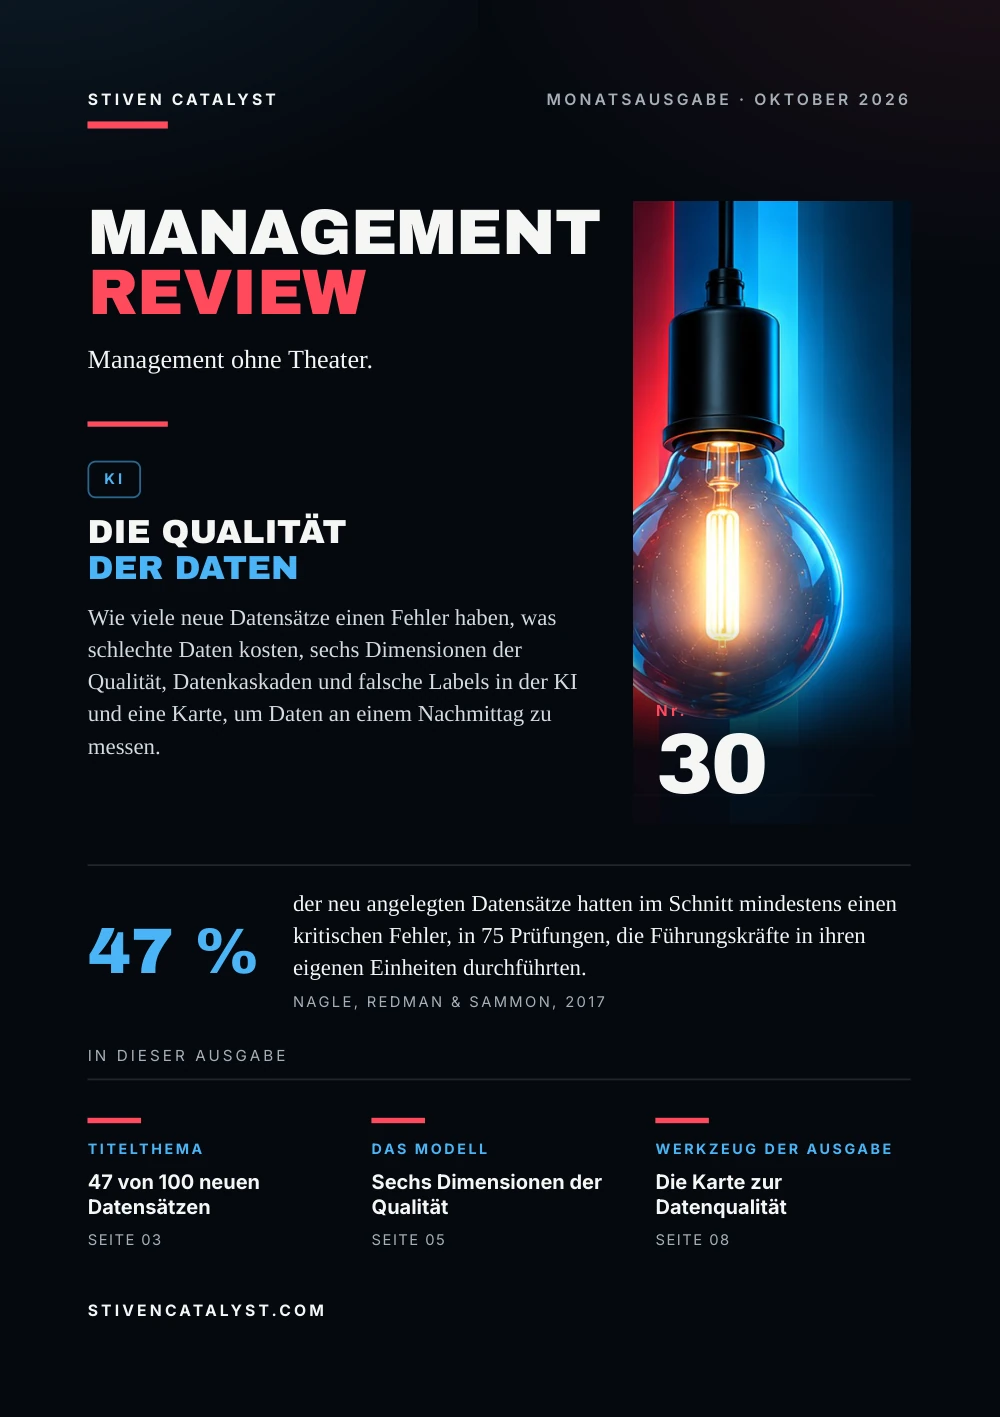
Management Review · Monatsausgabe · Oktober 2026 · Nr. 30
Die Qualität der Daten
Wie viele neue Datensätze einen Fehler haben, was schlechte Daten kosten, sechs Dimensionen der Qualität, Datenkaskaden und falsche Labels in der KI und eine Karte, um Daten an einem Nachmittag zu messen.
- Nr.
- 30
- Seiten
- 10
- Quellen
- 8
- Themen
- KI
Stiven CatalystMonatsausgabe · Oktober 2026
ManagementReview
Management ohne Theater.
KI
Die Qualitätder Daten
Wie viele neue Datensätze einen Fehler haben, was schlechte Daten kosten, sechs Dimensionen der Qualität, Datenkaskaden und falsche Labels in der KI und eine Karte, um Daten an einem Nachmittag zu messen.

Nr.30
47 %
der neu angelegten Datensätze hatten im Schnitt mindestens einen kritischen Fehler, in 75 Prüfungen, die Führungskräfte in ihren eigenen Einheiten durchführten.Nagle, Redman & Sammon, 2017
stivencatalyst.com
Nr. 30 · KI
In dieser Ausgabe
Jeder Bericht, jede Kennzahl und jedes KI-Modell ist nur so gut wie die Datensätze dahinter. Diese Ausgabe fragt, wie viele davon falsch sind, was das kostet und wie ein Team es an einem Nachmittag herausfindet.
- 03Titelthema47 von 100 neuen Datensätzen
- 04Die ZahlenWas schlechte Daten kosten
- 05Das ModellSechs Dimensionen der Qualität
- 06Was die Forschung sagtAlle wollen die Modellarbeit
- 07Wie man es misstDie Messung am Freitagnachmittag
- 08Werkzeug der AusgabeDie Karte zur Datenqualität
- 09QuellenQuellen und Methode
So lesen Sie diese Ausgabe
Zahl
Jede Zahl hat Quelle und Jahr unten auf ihrer Seite.
Unsere Lesart
Wo die Redaktion deutet und nicht die Forschung, steht es dabei.
Praxis
Schritte und Karte sind Vorschläge zum Ausprobieren, keine Forschungsergebnisse.
Titelthema
47 von 100neuen Datensät zen
Innerhalb von zwei Jahren machten 75 Führungskräfte denselben Test in ihren eigenen Einheiten: Sie nahmen die letzten 100 Datensätze, die ihre Teams angelegt oder genutzt hatten, und zählten die ohne kritischen Fehler, also ohne Fehler, der die Arbeit beeinträchtigt.
der neu angelegten Datensätze hatten im Schnitt mindestens einen kritischen Fehler.
Gefragt, wie gut die Daten sein müssten, nannte keine Führungskraft einen Wert unter den hohen Neunzigern akzeptabel, und weniger als 3 % der Werte erreichten diese Schwelle. Die Werte reichten von 0 bis 99, und die Autoren fanden keine nennenswerten Unterschiede zwischen Branchen.
Unsere Lesart
Der Test dauert einen Nachmittag und braucht keine Software. Schwer ist nur, die Datensätze anzusehen, die das eigene Team angelegt hat.
Quelle: Tadhg Nagle, Thomas C. Redman & David Sammon, Harvard Business Review, 2017
75 Messungen von Führungskräften in ihren eigenen Einheiten: eine kleine, nicht repräsentative Stichprobe. Die Schwelle setzten die Führungskräfte selbst, und die 3 % sind Messungen, keine Unternehmen.
Die Zahlen
Was schlechteDaten kosten
Die vollen Kosten schlechter Daten hat niemand gemessen. Es gibt Schätzungen und Faustregeln, die man zusammen mit ihren Vorbehalten lesen sollte.
12,9 Mio. $pro Jahr: Gartners durchschnittliche Kosten schlechter Datenqualität je Organisation (2021)
50 %der Zeit von Wissensarbeitern gehen laut Redman in versteckten Datenfabriken verloren
44 %der deutschen Unternehmen, die KI erwogen, aber nicht nutzen, nennen Verfügbarkeit oder Qualität der Daten (2025)
Kosten von 100 Arbeitseinheiten zu je 1 Dollar nach Redmans Zehnerregel ($)
Redman nennt die zusätzlichen Schritte, mit denen ein Team Fehler von weiter vorn auffängt, versteckte Datenfabriken, und seine Zehnerregel besagt, dass fehlerhafte Daten eine Arbeitseinheit zehnmal so teuer machen. Beides sind seine Schätzungen, keine Messungen. Die bekannteste Zahl, 3,1 Billionen Dollar pro Jahr für die USA im Jahr 2016, stammte von IBM; Redman schrieb später, sie könne in beide Richtungen um eine Billion danebenliegen.
Quellen: Manasi Sakpal, Gartner, 2021; Thomas C. Redman, Harvard Business Review, 2016 (über SAP Community, 2023); Statistisches Bundesamt (Destatis), 2025; Tadhg Nagle, Thomas C. Redman & David Sammon, Harvard Business Review, 2017
Schätzungen, keine Messungen, die man weder addieren noch vergleichen sollte. Gartner zeigt nicht, wie der Durchschnitt zustande kam; die deutsche Zahl ist ein Grund, den Firmen selbst angeben, kein Maß der Datenqualität.
Das Modell
Sechs Dimensionender Qualität
2013 benannte eine Arbeitsgruppe von DAMA UK, dem Verband für Datenmanagement, sechs Hauptdimensionen zur Bewertung der Datenqualität. Die britische Regierung übernahm sie 2020 in ihr Rahmenwerk.
01
Vollständigkeit
nichts fehlt, was da sein sollte
02
Eindeutigkeit
kein Datensatz kommt doppelt vor
03
Aktualität
Änderungen an der Quelle kommen schnell bei den Nutzern an
04
Gültigkeit
Werte entsprechen dem vereinbarten Format und den Regeln
05
Genauigkeit
die Daten bilden die Wirklichkeit ab
06
Konsistenz
Quellen stimmen überein, was die Daten noch nicht richtig macht
Für KI setzt Gartner einen anderen Maßstab: Daten sind KI-tauglich, wenn sie den Anwendungsfall abbilden, samt den Mustern, Fehlern und Ausreißern, die ein Modell braucht. In einer Gartner-Umfrage von 2024 unter 1.203 Datenverantwortlichen sagten 63 %, ihrer Organisation fehlten die richtigen Datenpraktiken für KI oder sie wüssten es nicht.
Unsere Lesart
Sauber heißt nicht brauchbar. Die Frage ist immer: gut genug wofür?
Quellen: DAMA UK Working Group, 2013 (über UK Government Data Quality Framework, 2020); Gartner, 2025
Die Definitionen folgen Zusammenfassungen des DAMA-UK-Dokuments; DAMA-DMBOK und andere Quellen nennen längere Listen. Die 63 % sind eine Selbstauskunft.
Mehr im EssayFehler gehen zwischen den Abteilungen verloren
Was die Forschung sagt
Alle wollendie Modellarbeit
Nithya Sambasivan und Kollegen bei Google befragten 53 Fachleute, die KI für folgenreiche Einsätze in Indien, Ost- und Westafrika und den USA entwickeln. 92 % hatten mindestens eine Datenkaskade erlebt: ein Datenproblem, das sich aufschaukelt und weiter hinten in der Kette den Ergebnissen schadet.
Falsche Labels in den Testdaten verbreiteter Benchmarks (%)
Curtis Northcutt, Anish Athalye und Jonas Mueller fanden in den Testdaten von zehn verbreiteten Datensammlungen mit Bildern, Text und Audio im Schnitt mindestens 3,3 % falsche Labels. Solche Fehler können die Rangfolge von Modellen umkehren: Bei ImageNet schlägt das kleinere ResNet-18 das ResNet-50, wenn der Anteil ursprünglich falsch beschrifteter Testbeispiele um nur 6 % steigt.
Unsere Lesart
Ein Modell wird an Daten gemessen. Sind die Daten falsch, ist es auch das Urteil.
Quellen: Nithya Sambasivan et al., ACM CHI, 2021; Curtis G. Northcutt, Anish Athalye & Jonas Mueller, NeurIPS Datasets and Benchmarks, 2021
Interviews mit 53 Personen, keine repräsentative Umfrage; öffentliche Testdaten, keine Unternehmensdaten. Fassungen der Studie nennen 3,3 % oder 3,4 %.
Wie man es misst
Die Messung amFreitagnachmit tag
Die Methode von Nagle, Redman und Sammon braucht keine Software: ein Team, einen Nachmittag und die letzten 100 Datensätze, die es angelegt oder genutzt hat.
Die letzten 100 Datensätze nehmen
die zuletzt in der eigenen Einheit angelegt oder genutzt wurden
Die 10–15 wichtigsten Felder wählen
die, von denen der nächste Schritt abhängt
Jeden sichtbaren Fehler markieren
Datensatz für Datensatz, mit Menschen, die die Daten kennen
Die fehlerfreien Datensätze zählen
diese Zahl von 0 bis 100 ist der Wert
Hypothetisches Beispiel, 100 Kundenaufträge
- Fehler
- falsche Adresse bei 9, keine Telefonnummer bei 14, falsche Menge bei 5; 4 Aufträge haben zwei Fehler
- Wert
- 24 Aufträge sind fehlerhaft, 76 sind sauber: Wert 76
- Zehnerregel
- Arbeit für 100 $ kostet 76 + 24 × 10 = 316 $
Aufträge und Fehler sind erfunden.
Quelle: Tadhg Nagle, Thomas C. Redman & David Sammon, Harvard Business Review, 2017
Die Schritte folgen Nagle, Redman & Sammon (2017); die Zehnerregel ist Redmans Faustregel; das Beispiel stammt von der Redaktion.
Werkzeug der Ausgabe
Die Kar te zurDatenqualität
Eine Karte pro Prüfung, einmal im Monat. Fehler je Feld zählen und dann sortieren: Meist entfällt der Großteil auf wenige Felder.
01Geprüfte Datensätzewelche 100, aus welchem Schritt, an welchem Tag
02Kritische Felderdie 10–15 Felder, von denen der nächste Schritt abhängt
03Fehler je Feldfehlend, falsch, doppelt oder veraltet
04Wertfehlerfreie Datensätze von 100
05Wo Fehler entstehender Schritt oder das System, wo die meisten entstehen
06An der Quelle behebeneine Änderung, wer, bis wann; im nächsten Monat neu messen
Quellen: Tadhg Nagle, Thomas C. Redman & David Sammon, Harvard Business Review, 2017; DAMA UK Working Group, 2013 (über UK Government Data Quality Framework, 2020)
Eine Praxis, die die Redaktion vorschlägt, nach der Freitagnachmittags-Messung (2017) und den DAMA-UK-Dimensionen (2013).
Tool öffnen: Pareto 80/20stivencatalyst.com/de/tools/pareto/
Quellen und Methode
Jede Zahlhat eine Quelle.
Die Zahlen dieser Ausgabe stammen aus den folgenden Quellen. Das Jahr zeigt, wie aktuell jede ist.
- Only 3% of Companies’ Data Meets Basic Quality StandardsTadhg Nagle, Thomas C. Redman & David Sammon, Harvard Business Review, 2017https://hbr.org/2017/09/only-3-of-companies-data-meets-basic-quality-standards
- Gründe gegen die Nutzung von Technologien der künstlichen Intelligenz nach BeschäftigtengrößenklassenStatistisches Bundesamt (Destatis), 2025https://www.destatis.de/DE/Themen/Branchen-Unternehmen/Unternehmen/IKT-in-Unternehmen-IKT-Branche/Tabellen/ikti-gegen-nutzung-kuenstliche-intelligenz.html
- “Everyone wants to do the model work, not the data work”: Data Cascades in High-Stakes AINithya Sambasivan et al., ACM CHI, 2021https://research.google/pubs/everyone-wants-to-do-the-model-work-not-the-data-work-data-cascades-in-high-stakes-ai/
- Pervasive Label Errors in Test Sets Destabilize Machine Learning BenchmarksCurtis G. Northcutt, Anish Athalye & Jonas Mueller, NeurIPS Datasets and Benchmarks, 2021https://arxiv.org/abs/2103.14749
- Bad Data Costs the U.S. $3 Trillion Per YearThomas C. Redman, Harvard Business Review, 2016 · über SAP Community, 2023https://hbr.org/2016/09/bad-data-costs-the-u-s-3-trillion-per-year
- Lack of AI-Ready Data Puts AI Projects at RiskGartner, 2025https://www.gartner.com/en/newsroom/press-releases/2025-02-26-lack-of-ai-ready-data-puts-ai-projects-at-risk
- How to Improve Your Data QualityManasi Sakpal, Gartner, 2021https://www.gartner.com/smarterwithgartner/how-to-improve-your-data-quality
- The Six Primary Dimensions for Data Quality AssessmentDAMA UK Working Group, 2013 · über UK Government Data Quality Framework, 2020
Redaktionelle Methode
Jede Zahl wurde auf Jahr, Herausgeber und genaue Bedeutung geprüft. Wo die Seite des Herausgebers nicht erreichbar war, wurde sie an unabhängigen Zusammenfassungen geprüft und mit „über“ markiert. Die Deutung der Redaktion ist als „Unsere Lesart“ markiert. Zahlen, die sich nicht bestätigen ließen, stehen nicht in der Ausgabe.
ManagementReview
Management ohne Theater.
Jede Ausgabe eine Führungsfrage, geprüft an der besten Forschung.
Alle Ausgaben
stivencatalyst.com/de/magazine/management-review.html
Management Review · Nr. 30 · Oktober 2026 · Stiven Catalyst
Zum Umblättern auf eine Seite klicken oder wischen. Die Pfeiltasten gehen auch.
Management Review · Nr. 30
Die Zahlen der Ausgabe
Die Grafiken der gedruckten Seiten, mit ihren Quellen.
47 % der neu angelegten Datensätze hatten im Schnitt mindestens einen kritischen Fehler.
Quelle: Tadhg Nagle, Thomas C. Redman & David Sammon, Harvard Business Review, 2017
Quelle: Tadhg Nagle, Thomas C. Redman & David Sammon, Harvard Business Review, 2017
Quelle: Curtis G. Northcutt, Anish Athalye & Jonas Mueller, NeurIPS Datasets and Benchmarks, 2021
Der ganze Text Die Ausgabe als Text lesen Zum Lesen auf kleinen Bildschirmen, zum Suchen oder mit Screenreader. Dieselben Worte, ohne die Seitengestaltung.
In dieser Ausgabe
Jeder Bericht, jede Kennzahl und jedes KI-Modell ist nur so gut wie die Datensätze dahinter. Diese Ausgabe fragt, wie viele davon falsch sind, was das kostet und wie ein Team es an einem Nachmittag herausfindet.
Als 75 Führungskräfte die neuesten Datensätze ihrer eigenen Einheiten prüften, hatten im Schnitt 47 % mindestens einen kritischen Fehler, und weniger als 3 % der Werte erreichten die selbst gesetzte Schwelle. Kostenschätzungen reichen von Gartners 12,9 Millionen Dollar pro Jahr und Organisation bis zu IBMs 3,1 Billionen Dollar für die USA, keine mit erkennbarer Methode. In der KI hatten 92 % von 53 befragten Fachleuten eine Datenkaskade erlebt, und die Testdaten verbreiteter Benchmarks enthalten im Schnitt mindestens 3,3 % falsche Labels.
Stiven Janaqi, Herausgeber
Titelthema
47 von 100 neuen Datensät zen
Innerhalb von zwei Jahren machten 75 Führungskräfte denselben Test in ihren eigenen Einheiten: Sie nahmen die letzten 100 Datensätze, die ihre Teams angelegt oder genutzt hatten, und zählten die ohne kritischen Fehler, also ohne Fehler, der die Arbeit beeinträchtigt.
47 % der neu angelegten Datensätze hatten im Schnitt mindestens einen kritischen Fehler.
Gefragt, wie gut die Daten sein müssten, nannte keine Führungskraft einen Wert unter den hohen Neunzigern akzeptabel, und weniger als 3 % der Werte erreichten diese Schwelle. Die Werte reichten von 0 bis 99, und die Autoren fanden keine nennenswerten Unterschiede zwischen Branchen.
Unsere Lesar t
Der Test dauert einen Nachmittag und braucht keine Software. Schwer ist nur, die Datensätze anzusehen, die das eigene Team angelegt hat.
75 Messungen von Führungskräften in ihren eigenen Einheiten: eine kleine, nicht repräsentative Stichprobe. Die Schwelle setzten die Führungskräfte selbst, und die 3 % sind Messungen, keine Unternehmen.
Quelle: Tadhg Nagle, Thomas C. Redman & David Sammon, Harvard Business Review, 2017
Die Zahlen
Was schlechte Daten kosten
Die vollen Kosten schlechter Daten hat niemand gemessen. Es gibt Schätzungen und Faustregeln, die man zusammen mit ihren Vorbehalten lesen sollte.
- 12,9 Mio. $ pro Jahr: Gartners durchschnittliche Kosten schlechter Datenqualität je Organisation (2021)
- 50 % der Zeit von Wissensarbeitern gehen laut Redman in versteckten Datenfabriken verloren
- 44 % der deutschen Unternehmen, die KI erwogen, aber nicht nutzen, nennen Verfügbarkeit oder Qualität der Daten (2025)
Kosten von 100 Arbeitseinheiten zu je 1 Dollar nach Redmans Zehnerregel ($): Alle Daten sauber 100, 11 Datensätze fehlerhaft 199.
Redman nennt die zusätzlichen Schritte, mit denen ein Team Fehler von weiter vorn auffängt, versteckte Datenfabriken, und seine Zehnerregel besagt, dass fehlerhafte Daten eine Arbeitseinheit zehnmal so teuer machen. Beides sind seine Schätzungen, keine Messungen. Die bekannteste Zahl, 3,1 Billionen Dollar pro Jahr für die USA im Jahr 2016, stammte von IBM; Redman schrieb später, sie könne in beide Richtungen um eine Billion danebenliegen.
Schätzungen, keine Messungen, die man weder addieren noch vergleichen sollte. Gartner zeigt nicht, wie der Durchschnitt zustande kam; die deutsche Zahl ist ein Grund, den Firmen selbst angeben, kein Maß der Datenqualität.
Quellen: Manasi Sakpal, Gartner, 2021; Thomas C. Redman, Harvard Business Review, 2016 (über SAP Community, 2023); Statistisches Bundesamt (Destatis), 2025; Tadhg Nagle, Thomas C. Redman & David Sammon, Harvard Business Review, 2017
Das Modell
Sechs Dimensionen der Qualität
2013 benannte eine Arbeitsgruppe von DAMA UK, dem Verband für Datenmanagement, sechs Hauptdimensionen zur Bewertung der Datenqualität. Die britische Regierung übernahm sie 2020 in ihr Rahmenwerk.
- Vollständigkeit. nichts fehlt, was da sein sollte
- Eindeutigkeit. kein Datensatz kommt doppelt vor
- Aktualität. Änderungen an der Quelle kommen schnell bei den Nutzern an
- Gültigkeit. Werte entsprechen dem vereinbarten Format und den Regeln
- Genauigkeit. die Daten bilden die Wirklichkeit ab
- Konsistenz. Quellen stimmen überein, was die Daten noch nicht richtig macht
Für KI setzt Gartner einen anderen Maßstab: Daten sind KI-tauglich, wenn sie den Anwendungsfall abbilden, samt den Mustern, Fehlern und Ausreißern, die ein Modell braucht. In einer Gartner-Umfrage von 2024 unter 1.203 Datenverantwortlichen sagten 63 %, ihrer Organisation fehlten die richtigen Datenpraktiken für KI oder sie wüssten es nicht.
Unsere Lesar t
Sauber heißt nicht brauchbar. Die Frage ist immer: gut genug wofür?
Die Definitionen folgen Zusammenfassungen des DAMA-UK-Dokuments; DAMA-DMBOK und andere Quellen nennen längere Listen. Die 63 % sind eine Selbstauskunft.
Quellen: DAMA UK Working Group, 2013 (über UK Government Data Quality Framework, 2020); Gartner, 2025
Mehr im Essay: Fehler gehen zwischen den Abteilungen verloren
Was die Forschung sagt
Alle wollen die Modellarbeit
Nithya Sambasivan und Kollegen bei Google befragten 53 Fachleute, die KI für folgenreiche Einsätze in Indien, Ost- und Westafrika und den USA entwickeln. 92 % hatten mindestens eine Datenkaskade erlebt: ein Datenproblem, das sich aufschaukelt und weiter hinten in der Kette den Ergebnissen schadet.
Falsche Labels in den Testdaten verbreiteter Benchmarks (%): MNIST 0,15, Durchschnitt von 10 Datensammlungen 3,3, ImageNet, Validierungsdaten 6, QuickDraw 10,12.
Curtis Northcutt, Anish Athalye und Jonas Mueller fanden in den Testdaten von zehn verbreiteten Datensammlungen mit Bildern, Text und Audio im Schnitt mindestens 3,3 % falsche Labels. Solche Fehler können die Rangfolge von Modellen umkehren: Bei ImageNet schlägt das kleinere ResNet-18 das ResNet-50, wenn der Anteil ursprünglich falsch beschrifteter Testbeispiele um nur 6 % steigt.
Unsere Lesar t
Ein Modell wird an Daten gemessen. Sind die Daten falsch, ist es auch das Urteil.
Interviews mit 53 Personen, keine repräsentative Umfrage; öffentliche Testdaten, keine Unternehmensdaten. Fassungen der Studie nennen 3,3 % oder 3,4 %.
Quellen: Nithya Sambasivan et al., ACM CHI, 2021; Curtis G. Northcutt, Anish Athalye & Jonas Mueller, NeurIPS Datasets and Benchmarks, 2021
Wie man es misst
Die Messung am Freitagnachmit tag
Die Methode von Nagle, Redman und Sammon braucht keine Software: ein Team, einen Nachmittag und die letzten 100 Datensätze, die es angelegt oder genutzt hat.
- Die l
e t z ten 100 Datensät ze nehmen. die zuletzt in der eigenen Einheit angelegt oder genutzt wurden - Die 10–15 wichtigsten Felder wählen. die, von denen der nächste Schritt abhängt
- Jeden sichtbaren Fehler markieren. Datensatz für Datensatz, mit Menschen, die die Daten kennen
- Die fehlerfreien Datensä
t ze zählen. diese Zahl von 0 bis 100 ist der Wert
Hypothe tisches Beispiel, 100 Kundenauf träge
- Fehler: falsche Adresse bei 9, keine Telefonnummer bei 14, falsche Menge bei 5; 4 Aufträge haben zwei Fehler
- We
r t: 24 Aufträge sind fehlerhaft, 76 sind sauber: Wert 76 - Zehnerregel: Arbeit für 100 $ kostet 76 + 24 × 10 = 316 $
Aufträge und Fehler sind erfunden.
Die Schritte folgen Nagle, Redman & Sammon (2017); die Zehnerregel ist Redmans Faustregel; das Beispiel stammt von der Redaktion.
Quelle: Tadhg Nagle, Thomas C. Redman & David Sammon, Harvard Business Review, 2017
Werkzeug der Ausgabe
Die Kar te zur Datenqualität
Eine Karte pro Prüfung, einmal im Monat. Fehler je Feld zählen und dann sortieren: Meist entfällt der Großteil auf wenige Felder.
- Geprü
f te Datensät ze welche 100, aus welchem Schritt, an welchem Tag - Kritische Felder die 10–15 Felder, von denen der nächste Schritt abhängt
- Fehler je Feld fehlend, falsch, doppelt oder veraltet
- We
r t fehlerfreie Datensätze von 100 - Wo Fehler entstehen der Schritt oder das System, wo die meisten entstehen
- An der Quelle beheben eine Änderung, wer, bis wann; im nächsten Monat neu messen
Eine Praxis, die die Redaktion vorschlägt, nach der Freitagnachmittags-Messung (2017) und den DAMA-UK-Dimensionen (2013).
Quellen: Tadhg Nagle, Thomas C. Redman & David Sammon, Harvard Business Review, 2017; DAMA UK Working Group, 2013 (über UK Government Data Quality Framework, 2020)
Tool öffnen: Pareto 80/20
Quellen und Methode
Jede Zahl hat eine Quelle.
Die Zahlen dieser Ausgabe stammen aus den folgenden Quellen. Das Jahr zeigt, wie aktuell jede ist.
- Tadhg Nagle, Thomas C. Redman & David Sammon, Harvard Business Review, “Only 3% of Companies’ Data Meets Basic Quality Standards”, 2017. https://hbr.org/2017/09/only-3-of-companies-data-meets-basic-quality-standards
- Statistisches Bundesamt (Destatis), “Gründe gegen die Nutzung von Technologien der künstlichen Intelligenz nach Beschäftigtengrößenklassen”, 2025. https://www.destatis.de/DE/Themen/Branchen-Unternehmen/Unternehmen/IKT-in-Unternehmen-IKT-Branche/Tabellen/ikti-gegen-nutzung-kuenstliche-intelligenz.html
- Nithya Sambasivan et al., ACM CHI, ““Everyone wants to do the model work, not the data work”: Data Cascades in High-Stakes AI”, 2021. https://research.google/pubs/everyone-wants-to-do-the-model-work-not-the-data-work-data-cascades-in-high-stakes-ai/
- Curtis G. Northcutt, Anish Athalye & Jonas Mueller, NeurIPS Datasets and Benchmarks, “Pervasive Label Errors in Test Sets Destabilize Machine Learning Benchmarks”, 2021. https://arxiv.org/abs/2103.14749
- Thomas C. Redman, Harvard Business Review, “Bad Data Costs the U.S. $3 Trillion Per Year”, 2016 (über SAP Community, 2023). https://hbr.org/2016/09/bad-data-costs-the-u-s-3-trillion-per-year
- Gartner, “Lack of AI-Ready Data Puts AI Projects at Risk”, 2025. https://www.gartner.com/en/newsroom/press-releases/2025-02-26-lack-of-ai-ready-data-puts-ai-projects-at-risk
- Manasi Sakpal, Gartner, “How to Improve Your Data Quality”, 2021. https://www.gartner.com/smarterwithgartner/how-to-improve-your-data-quality
- DAMA UK Working Group, “The Six Primary Dimensions for Data Quality Assessment”, 2013 (über UK Government Data Quality Framework, 2020).
Redaktionelle Me thode
Jede Zahl wurde auf Jahr, Herausgeber und genaue Bedeutung geprüft. Wo die Seite des Herausgebers nicht erreichbar war, wurde sie an unabhängigen Zusammenfassungen geprüft und mit „über“ markiert. Die Deutung der Redaktion ist als „Unsere Lesart“ markiert. Zahlen, die sich nicht bestätigen ließen, stehen nicht in der Ausgabe.
Management Review · Monatsausgabe