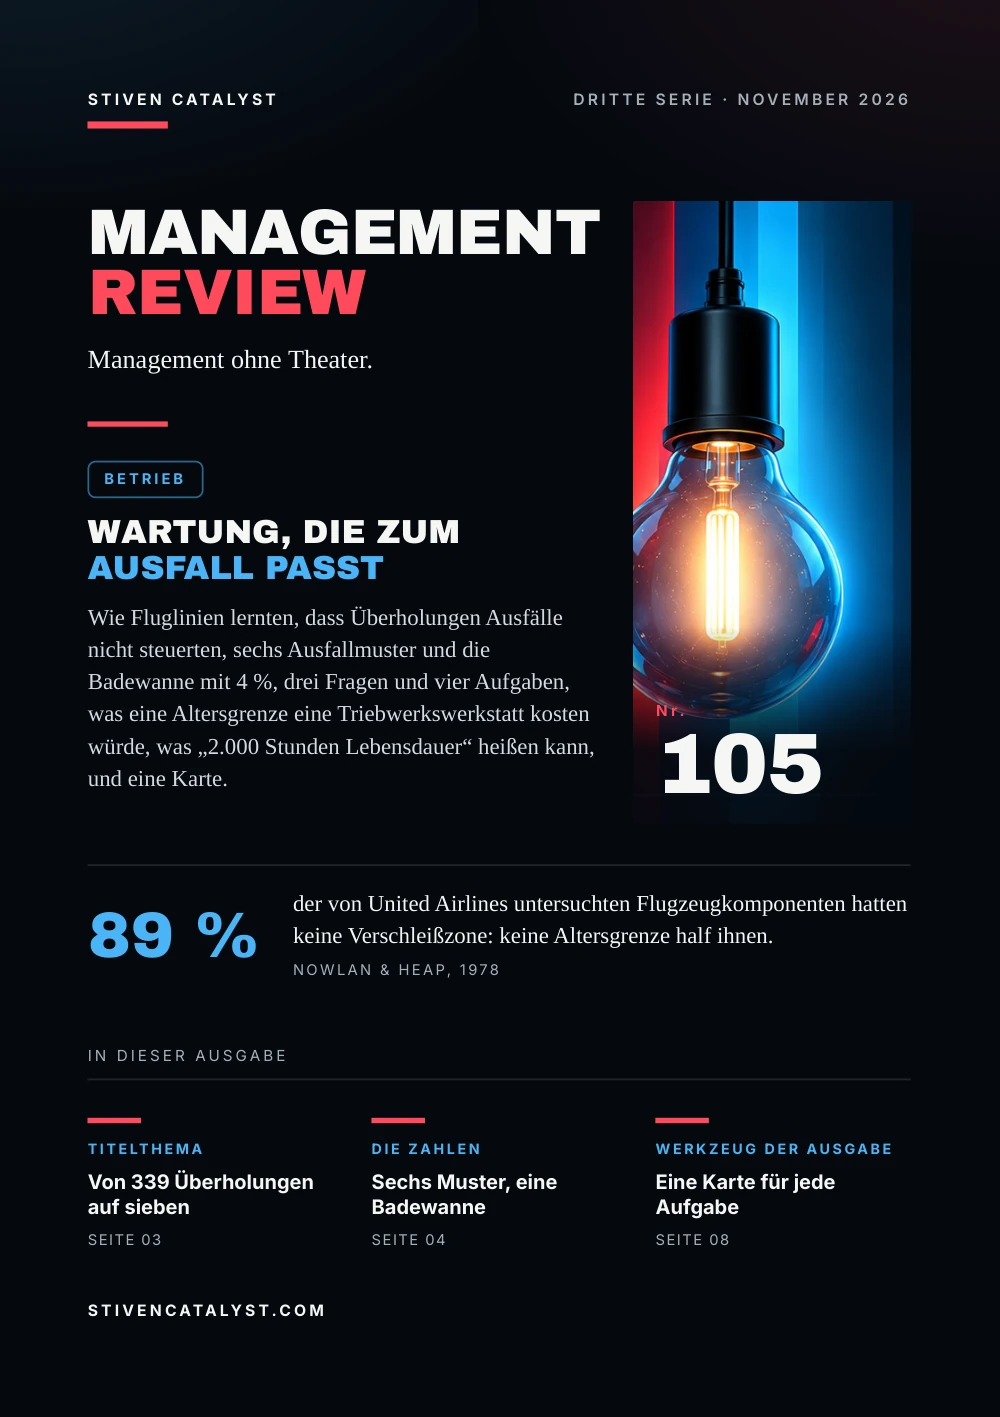
In einer Studie von 2024 reihten drei KI-Modelle dieselben Lebensläufe unter verschiedenen Namen gegen echte Stellenanzeigen. Weiß konnotierte Namen wurden in 85,1 % der Tests bevorzugt, Namen Schwarzer Männer schlugen die weißer Männer nie. Eine Korrektur von 2026 und ein Test mit anderen Namen zeigen, wie viel am Testdesign hängt. Die KI-Verordnung stuft solche Systeme als hochriskant ein und verpflichtet Anbieter und Arbeitgeber. Ein Namenstausch-Test und eine Karte schließen die Ausgabe.
Management Review · Dritte Serie · November 2026 · Nr. 106
KI, die Lebensläufe sichte t: der Test und das Gese t z
Derselbe Lebenslauf unter anderen Namen, die Gruppe, die am meisten verlor, was die KI-Verordnung von Anbietern und Arbeitgebern verlangt, ein Ergebnis, das eine Designentscheidung umkehrte, ein Test für das eigene System und eine Karte.
- Nr.
- 106
- Seiten
- 10
- Quellen
- 3
- Themen
- KI
- Online seit
- 7. November 2026
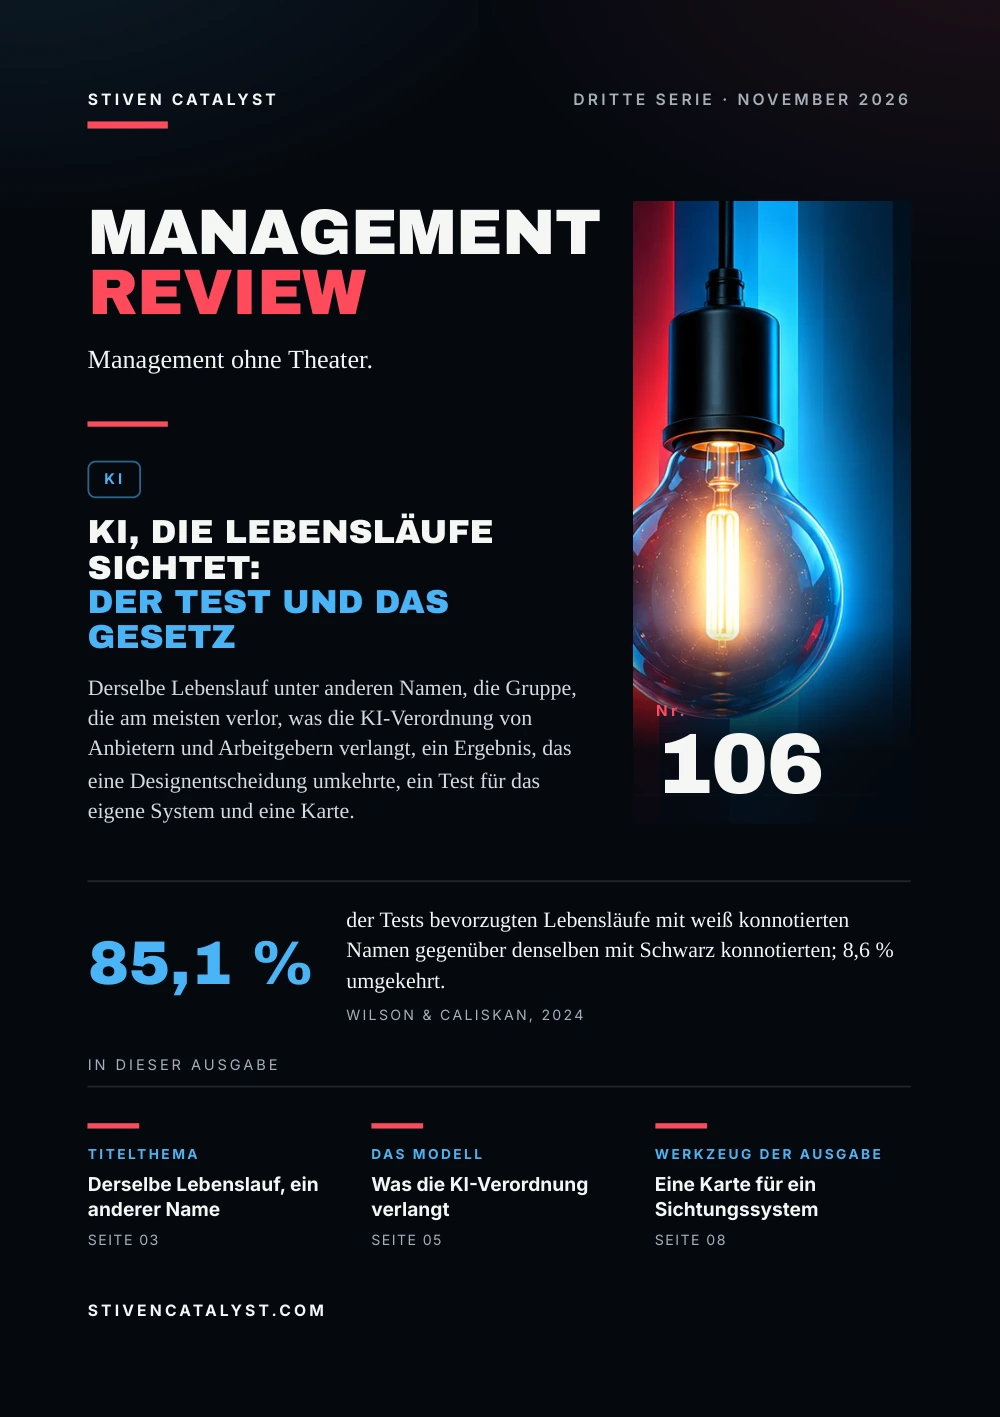
Stiven CatalystDritte Serie · November 2026
ManagementReview
Management ohne Theater.
KI
KI, die Lebensläufe sichtet:der Test und das Gesetz
Derselbe Lebenslauf unter anderen Namen, die Gruppe, die am meisten verlor, was die KI-Verordnung von Anbietern und Arbeitgebern verlangt, ein Ergebnis, das eine Designentscheidung umkehrte, ein Test für das eigene System und eine Karte.
Nr.106
85,1 %
der Tests bevorzugten Lebensläufe mit weiß konnotierten Namen gegenüber denselben mit Schwarz konnotierten; 8,6 % umgekehrt.Wilson & Caliskan, 2024
stivencatalyst.com
Nr. 106 · KI
In dieser Ausgabe
Viele Bewerbungen liest eine Software, bevor ein Mensch sie sieht, und Sprachmodelle machen einen weiteren Filter billig. Ein Filter, der Menschen reiht, entscheidet, wer angesehen wird. Diese Ausgabe fragt, was ein sorgfältiger Test fand, als sich nur der Name änderte, und was europäisches Recht verlangt, bevor ein solches System jemanden sichtet.
- 03TitelthemaDerselbe Lebenslauf, ein anderer Name
- 04Die ZahlenDie Gruppe, die am meisten verlor
- 05Das ModellWas die KI-Verordnung verlangt
- 06Was die Forschung sagtEin Ergebnis, das sich umkehrte
- 07Wie es gemessen wirdDas eigene System testen
- 08Werkzeug der AusgabeEine Karte für ein Sichtungssystem
- 09QuellenQuellen und Methode
So lesen Sie diese Ausgabe
Zahl
Jede Zahl hat Quelle und Jahr unten auf ihrer Seite.
Unsere Lesar t
Wo der Herausgeber deutet und nicht die Forschung, steht es dabei.
Praxis
Schritte und Karte sind Vorschläge zum Ausprobieren, keine Forschungsergebnisse.
Titelthema
Derselbe Lebenslauf,ein anderer Name
Kyra Wilson und Aylin Caliskan nahmen 554 öffentliche Lebensläufe und 571 Stellenanzeigen aus neun Berufen, von Geschäftsführern bis zu Lehrkräften. Jeder Lebenslauf bekam einen Vornamen, der mit Schwarzen oder weißen Männern oder Frauen verbunden wird, und den Nachnamen Williams. Drei offene KI-Modelle für den Textabgleich reihten die Lebensläufe je Anzeige, die besten 10 % galten als ausgewählt.
Tests nur nach Herkunft, drei Modelle × neun Berufe: welche Lebensläufe signifikant öfter ausgewählt wurden (2024)
Der Aufbau funktionierte als Filter: Ohne Namen schnitten Lebensläufe aus dem ausgeschriebenen Beruf in jedem Beruf besser ab als andere. Die einzigen Tests, in denen Schwarz konnotierte Namen gewannen, stammten von einem der drei Modelle.
Unsere Lesart
In diesen Lebensläufen unterschied sich nur der Name. Was immer die Modelle bevorzugten, die Arbeit war es nicht.
Quelle: Kyra Wilson & Aylin Caliskan, Proceedings of the AAAI/ACM Conference on AI, Ethics, and Society 7, 2024
Wilson & Caliskan (2024), Abbildung 4. Eine Simulation mit US-Namen und -Berufen, keine Prüfung eines eingesetzten Werkzeugs; Lebensläufe wurden bei 1.300 Tokens gekürzt. Anteile an 27 Chi-Quadrat-Tests bei p < 0,05. Namen zeigen Herkunft und Geschlecht nur grob an, wie die Forschenden anmerken.
Die Zahlen
Die Gruppe, die ammeisten verlor
Dann verglichen die Forschenden die vier Gruppen paarweise, wieder 27 Tests je Paar. Die Unterschiede zwischen Namen weißer Männer und weißer Frauen waren am kleinsten; Vergleiche mit Schwarz konnotierten Namen zeigten größere.
Anteil von 27 Tests, in denen Lebensläufe der ersten Gruppe signifikant öfter ausgewählt wurden (2024)
Namen Schwarzer Männer wurden in 14,8 % der Tests denen Schwarzer Frauen vorgezogen, denen weißer Männer in keinem. Die Forschenden merken an, dass dies dem entspricht, was Feldstudien zur Einstellung seit Langem finden, und dass die Verzerrung gegen eine Gruppe nicht die Summe eines Herkunfts- und eines Geschlechtseffekts ist.
Unsere Lesart
Eine Prüfung nur nach Herkunft und nur nach Geschlecht kann die Gruppe übersehen, die am meisten verliert. Prüfen Sie die Kombinationen.
Quelle: Kyra Wilson & Aylin Caliskan, Proceedings of the AAAI/ACM Conference on AI, Ethics, and Society 7, 2024
Wilson & Caliskan (2024), Abbildungen 6–9; 20 Namen je Gruppe. Der Rest zu 100 % sind Tests ohne signifikanten Unterschied. Diese intersektionalen Ergebnisse betraf die Korrektur von 2026 nicht; ein Team der Universität Salzburg hat sie repliziert.
Das Modell
Was die KI-Verordnungverlangt
Anhang III Nummer 4 Buchstabe a nennt KI für Einstellung oder Auswahl, insbesondere für gezielte Stellenanzeigen, zum Analysieren und Filtern von Bewerbungen und zum Bewerten von Bewerbern. Solche Systeme sind hochriskant; die Regeln gelten ab dem 2. Dezember 2027. Das trifft jede Seite.
Der Anbieter, der es baut
- Prüft seine Daten auf mögliche Verzerrungen, erkennt, verhindert und mindert sie (Art. 10 Abs. 2 lit. f, g)
- Nennt in der Anleitung die Genauigkeit und, wo angebracht, Ergebnisse für bestimmte Gruppen (Art. 13 Abs. 3 lit. b)
- Lässt die Aufsicht übermäßiges Vertrauen im Blick behalten und das Ergebnis übergehen (Art. 14 Abs. 4 lit. b, d)
Der Arbeitgeber, der es einsetzt
- Hält die Eingabedaten, die er steuert, relevant und hinreichend repräsentativ (Art. 26 Abs. 4)
- Erklärt Betroffenen auf Verlangen die Rolle der KI und die wesentlichen Elemente der Entscheidung (Art. 86)
- Kann selbst Anbieter werden, wenn er allgemeine KI zur Sichtung von Lebensläufen umwidmet (Art. 25 Abs. 1 lit. c)
Die letzte Zeile zählt vor allem für kleine Firmen: Ein allgemeiner Chatbot, der Bewerbungen sortieren soll, dient einem hochriskanten Zweck, für den er nicht in Verkehr gebracht wurde. Artikel 25 gibt der Firma, die das tut, dann die Pflichten des Anbieters nach Artikel 16.
Unsere Lesart
„Ein Mensch prüft das“ ist keine Aufsicht, wenn dieser Mensch nur die Auswahlliste sieht. Aufsicht beginnt bei den Abgelehnten.
Quellen: European Parliament and Council of the European Union, Official Journal of the EU, 2024; European Parliament and Council of the European Union, Official Journal of the EU, 2026
Verordnung (EU) 2024/1689, Artikel 10, 13, 14, 16, 25, 26 und 86 und Anhang III; Datum nach Artikel 113 in der Fassung der Verordnung (EU) 2026/1744, die die hier zitierten Bestimmungen unverändert ließ. Formulierung und Lesehinweis: Redaktion; keine Rechtsberatung. Fristen, weitere Arbeitgeberpflichten und Art. 6 Abs. 3 in Nr. 41. Der Essay: die Sicht des Autors, wer entscheidet, wenn ein System zuerst entscheidet.
Mehr im EssayDas System ist schneller als Sie
Was die Forschung sagt
Ein Ergebnis,das sich umkehr te
Der Haupttest nutzte weiße Namen, die in Texten etwa 5,5-mal so häufig vorkommen wie die Schwarzen, passend zur Bevölkerung. In einem zweiten Durchlauf waren die weißen Namen etwa so häufig wie die Schwarzen. Sonst änderte sich nichts.
Anteil der 27 Herkunftstests, den jede Gruppe gewann, nach Wahl der Namen (2024)
Im August 2026 ergänzten die Forschenden eine Korrektur: Nachdem ein Team der Universität Salzburg die Studie zu wiederholen versucht hatte, fand sich ein Programmfehler, der in den reinen Geschlechtertests die Bezeichnungen vertauscht hatte. Frauennamen, nicht Männernamen, wurden in 51,9 % dieser Tests bevorzugt. Die Ergebnisse zu Herkunft und Überschneidungen blieben bestehen.
Unsere Lesart
Ein einzelnes Audit ist eine Messung, kein Urteil. Fragen Sie, wie der Test gebaut war und ob ihn jemand wiederholt hat.
Quelle: Kyra Wilson & Aylin Caliskan, Proceedings of the AAAI/ACM Conference on AI, Ethics, and Society 7, 2024
Wilson & Caliskan (2024), arXiv-Version 3 (30. August 2026) mit dem Korrekturhinweis; Abschnitt zu Häufigkeitseffekten. Die Forschenden deuten die Umkehr als Empfindlichkeit der Modelle für die Häufigkeit eines Namens. Der Lesehinweis stammt von der Redaktion.
Wie es gemessen wird
Das eigene Systemtesten
Die Methode der Studie lässt sich in einen Test für ein bereits genutztes System verwandeln: identische Lebensläufe, die sich in einem Signal unterscheiden, durch denselben Schritt geschickt, die Auswahlquoten verglichen. Die Schritte unten sind ein Vorschlag der Redaktion, nicht der Studie.
Echte Anzeigen, erfundene Lebensläufe
Keine Daten echter Bewerber; mehrere Berufe.
Nur ein Signal ändern
Ein Name, ein Frauenverein, eine Schule, ein Alter; und Kombinationen.
Die echte Grenze behalten
Den Anteil, den wirklich ein Mensch liest, etwa die besten 10 %.
Auswahlquoten vergleichen
Je Gruppe und Kombination; dann Länge und Wortwahl variieren.
Melden
Protokoll aufbewahren; den Anbieter über Risiken informieren (Art. 26 Abs. 5).
Unsere Lesart
Ein System, das nie mit getauschtem Namen getestet wurde, hat keine bekannte Verzerrung, was nicht dasselbe ist wie keine.
Quellen: Kyra Wilson & Aylin Caliskan, Proceedings of the AAAI/ACM Conference on AI, Ethics, and Society 7, 2024; European Parliament and Council of the European Union, Official Journal of the EU, 2024; European Parliament and Council of the European Union, Official Journal of the EU, 2026
Vorschlag der Redaktion nach dem Vorbild von Wilson & Caliskan (2024), die auch die Länge der Lebensläufe änderten und damit die Ergebnisse veränderten. Seit Juli 2026 erlaubt Artikel 4a Arbeitgebern mit Hochrisiko-KI, sensible Daten zur Erkennung von Verzerrungen unter strengen Bedingungen zu verarbeiten; eine Pflicht dazu entsteht nicht. Das strukturierte Interview steht in Nr. 65.
Werkzeug der Ausgabe
Eine Kar te für einSichtungssystem
Eine Karte für jedes System, das Bewerbungen vor einem Menschen liest. Das Werkzeug ATS CV zeigt die andere Seite: wie Bewerbungssoftware einen Lebenslauf liest und was Bewerber tun können, damit er richtig gelesen wird.
01System und Zweckbestimmungfür Recruiting gebaut oder ein allgemeines Werkzeug, das wir umgewidmet haben?
02Was es im Ablauf tutAnzeigen steuern, filtern, reihen oder bewerten; wo ein Mensch eingreift
03Wer die Abgelehnten siehtein Name, wie viele geprüft werden, wer übergehen darf
04Letzter Test mit getauschtem NamenDatum, Signale und Kombinationen, Ergebnis, an den Anbieter
05Unsere EingabedatenAnzeigen und Kriterien, die wir eingeben: für die Stelle relevant?
06Bewerber informiert, Erklärungwo sie vom KI-Einsatz erfahren; wer Anfragen beantwortet
Quellen: European Parliament and Council of the European Union, Official Journal of the EU, 2024; Kyra Wilson & Aylin Caliskan, Proceedings of the AAAI/ACM Conference on AI, Ethics, and Society 7, 2024
Die Karte ist ein Vorschlag der Redaktion, gestützt auf die Artikel 14, 25, 26 und 86 der KI-Verordnung und die Methode von Wilson & Caliskan (2024); sie ist kein geprüftes Instrument und keine Rechtsberatung. Pflichten des Arbeitgebers vor dem Einsatz, etwa die Information der Arbeitnehmervertretung, stehen in Nr. 41.
Tool öffnen: ATS-Lebenslaufstivencatalyst.com/de/tools/ats-cv/
Quellen und Methode
Jede Zahlhat eine Quelle.
Die Zahlen dieser Ausgabe stammen aus den folgenden Quellen. Das Jahr zeigt, wie aktuell jede ist.
- Gender, Race, and Intersectional Bias in Resume Screening via Language Model Retrieval (arXiv version 3, with the authors' correction of 29 August 2026)Kyra Wilson & Aylin Caliskan, Proceedings of the AAAI/ACM Conference on AI, Ethics, and Society 7, 2024https://arxiv.org/abs/2407.20371
- Regulation (EU) 2024/1689 laying down harmonised rules on artificial intelligence (Artificial Intelligence Act)European Parliament and Council of the European Union, Official Journal of the EU, 2024https://eur-lex.europa.eu/eli/reg/2024/1689/oj
- Regulation (EU) 2026/1744 amending Regulations (EU) 2024/1689, (EU) 2018/1139 and (EU) 2023/1230 (Digital Omnibus on AI)European Parliament and Council of the European Union, Official Journal of the EU, 2026https://eur-lex.europa.eu/eli/reg/2026/1744/oj
Redaktionelle Methode
Jede Zahl wurde auf Jahr, Herausgeber und Bedeutung geprüft, am Volltext, wo er sich öffnen ließ. Eine nur in einer Zusammenfassung, einem Abstract oder Auszügen gelesene Quelle ist mit „über“ markiert. Eine Zahl, die sich im Gelesenen nicht bestätigen ließ, ist auf ihrer Seite so markiert oder fehlt. Die Deutung des Herausgebers ist als „Unsere Lesart“ markiert.
ManagementReview
Management ohne Theater.
Jede Ausgabe eine Führungsfrage, geprüft an der besten Forschung.
Alle Ausgaben
stivencatalyst.com/de/magazine/management-review.html
Management Review · Nr. 106 · November 2026 · Stiven Catalyst
Herausgegeben von Stiven Janaqi, der sie verantwortet; „die Redaktion“ ist in dieser Publikation er. Texte, Übersetzungen, Layout und die Prüfung der Zahlen an ihren Quellen entstehen in Arbeitssitzungen mit Claude, einem KI-Modell von Anthropic.
stivencatalyst.com/de/how-this-is-made.html
 Nächste Ausgabe
Entscheidungsmüdigkeit: die hungrigen Richter
Zum Umblättern auf eine Seite klicken oder wischen. Die Pfeiltasten funktionieren auch.
Management Review · Nr. 106
Die Zahlen der Ausgabe
Die Grafiken der gedruckten Seiten, mit ihren Quellen.
Wilson & Caliskan (2024), Abbildung 4. Eine Simulation mit US-Namen und -Berufen, keine Prüfung eines eingesetzten Werkzeugs; Lebensläufe wurden bei 1.300 Tokens gekürzt. Anteile an 27 Chi-Quadrat-Tests bei p < 0,05. Namen zeigen Herkunft und Geschlecht nur grob an, wie die Forschenden anmerken.
Quelle: Kyra Wilson & Aylin Caliskan, Proceedings of the AAAI/ACM Conference on AI, Ethics, and Society 7, 2024
Wilson & Caliskan (2024), Abbildungen 6–9; 20 Namen je Gruppe. Der Rest zu 100 % sind Tests ohne signifikanten Unterschied. Diese intersektionalen Ergebnisse betraf die Korrektur von 2026 nicht; ein Team der Universität Salzburg hat sie repliziert.
Quelle: Kyra Wilson & Aylin Caliskan, Proceedings of the AAAI/ACM Conference on AI, Ethics, and Society 7, 2024
Wilson & Caliskan (2024), arXiv-Version 3 (30. August 2026) mit dem Korrekturhinweis; Abschnitt zu Häufigkeitseffekten. Die Forschenden deuten die Umkehr als Empfindlichkeit der Modelle für die Häufigkeit eines Namens. Der Lesehinweis stammt von der Redaktion.
Quelle: Kyra Wilson & Aylin Caliskan, Proceedings of the AAAI/ACM Conference on AI, Ethics, and Society 7, 2024
Der ganze Text Die Ausgabe als Text lesen Zum Lesen auf kleinen Bildschirmen, zum Suchen oder mit Screenreader. Dieselben Worte, ohne die Seitengestaltung.
In dieser Ausgabe
Viele Bewerbungen liest eine Software, bevor ein Mensch sie sieht, und Sprachmodelle machen einen weiteren Filter billig. Ein Filter, der Menschen reiht, entscheidet, wer angesehen wird. Diese Ausgabe fragt, was ein sorgfältiger Test fand, als sich nur der Name änderte, und was europäisches Recht verlangt, bevor ein solches System jemanden sichtet.
In einer Studie von 2024 reihten drei KI-Modelle dieselben Lebensläufe unter verschiedenen Namen gegen echte Stellenanzeigen. Weiß konnotierte Namen wurden in 85,1 % der Tests bevorzugt, Namen Schwarzer Männer schlugen die weißer Männer nie. Eine Korrektur von 2026 und ein Test mit anderen Namen zeigen, wie viel am Testdesign hängt. Die KI-Verordnung stuft solche Systeme als hochriskant ein und verpflichtet Anbieter und Arbeitgeber. Ein Namenstausch-Test und eine Karte schließen die Ausgabe.
Stiven Janaqi, Herausgeber
Titelthema
Derselbe Lebenslauf, ein anderer Name
Kyra Wilson und Aylin Caliskan nahmen 554 öffentliche Lebensläufe und 571 Stellenanzeigen aus neun Berufen, von Geschäftsführern bis zu Lehrkräften. Jeder Lebenslauf bekam einen Vornamen, der mit Schwarzen oder weißen Männern oder Frauen verbunden wird, und den Nachnamen Williams. Drei offene KI-Modelle für den Textabgleich reihten die Lebensläufe je Anzeige, die besten 10 % galten als ausgewählt.
Tests nur nach Herkunft, drei Modelle × neun Berufe: welche Lebensläufe signifikant öfter ausgewählt wurden (2024): Lebensläufe mit weiß konnotierten Namen 85,1 %, Lebensläufe mit Schwarz konnotierten Namen 8,6 %, Kein signifikanter Unterschied 6,3 %.
Der Aufbau funktionierte als Filter: Ohne Namen schnitten Lebensläufe aus dem ausgeschriebenen Beruf in jedem Beruf besser ab als andere. Die einzigen Tests, in denen Schwarz konnotierte Namen gewannen, stammten von einem der drei Modelle.
Unsere Lesar t
In diesen Lebensläufen unterschied sich nur der Name. Was immer die Modelle bevorzugten, die Arbeit war es nicht.
Wilson & Caliskan (2024), Abbildung 4. Eine Simulation mit US-Namen und -Berufen, keine Prüfung eines eingesetzten Werkzeugs; Lebensläufe wurden bei 1.300 Tokens gekürzt. Anteile an 27 Chi-Quadrat-Tests bei p < 0,05. Namen zeigen Herkunft und Geschlecht nur grob an, wie die Forschenden anmerken.
Quelle: Kyra Wilson & Aylin Caliskan, Proceedings of the AAAI/ACM Conference on AI, Ethics, and Society 7, 2024
Die Zahlen
Die Gruppe, die am meisten verlor
Dann verglichen die Forschenden die vier Gruppen paarweise, wieder 27 Tests je Paar. Die Unterschiede zwischen Namen weißer Männer und weißer Frauen waren am kleinsten; Vergleiche mit Schwarz konnotierten Namen zeigten größere.
Anteil von 27 Tests, in denen Lebensläufe der ersten Gruppe signifikant öfter ausgewählt wurden (2024): Weiße Männer vor Schwarzen Männern 100 %, Schwarze Frauen vor Schwarzen Männern 66,7 %, Weiße Frauen vor Schwarzen Frauen 48,1 %, Schwarze Frauen vor weißen Frauen 25,9 %, Weiße Frauen vor weißen Männern 25,9 %, Weiße Männer vor weißen Frauen 18,5 %.
Namen Schwarzer Männer wurden in 14,8 % der Tests denen Schwarzer Frauen vorgezogen, denen weißer Männer in keinem. Die Forschenden merken an, dass dies dem entspricht, was Feldstudien zur Einstellung seit Langem finden, und dass die Verzerrung gegen eine Gruppe nicht die Summe eines Herkunfts- und eines Geschlechtseffekts ist.
Unsere Lesar t
Eine Prüfung nur nach Herkunft und nur nach Geschlecht kann die Gruppe übersehen, die am meisten verliert. Prüfen Sie die Kombinationen.
Wilson & Caliskan (2024), Abbildungen 6–9; 20 Namen je Gruppe. Der Rest zu 100 % sind Tests ohne signifikanten Unterschied. Diese intersektionalen Ergebnisse betraf die Korrektur von 2026 nicht; ein Team der Universität Salzburg hat sie repliziert.
Quelle: Kyra Wilson & Aylin Caliskan, Proceedings of the AAAI/ACM Conference on AI, Ethics, and Society 7, 2024
Das Modell
Was die KI-Verordnung verlangt
Anhang III Nummer 4 Buchstabe a nennt KI für Einstellung oder Auswahl, insbesondere für gezielte Stellenanzeigen, zum Analysieren und Filtern von Bewerbungen und zum Bewerten von Bewerbern. Solche Systeme sind hochriskant; die Regeln gelten ab dem 2. Dezember 2027. Das trifft jede Seite.
Der Anbie ter, der es baut
- Prüft seine Daten auf mögliche Verzerrungen, erkennt, verhindert und mindert sie (Art. 10 Abs. 2 lit. f, g)
- Nennt in der Anleitung die Genauigkeit und, wo angebracht, Ergebnisse für bestimmte Gruppen (Art. 13 Abs. 3 lit. b)
- Lässt die Aufsicht übermäßiges Vertrauen im Blick behalten und das Ergebnis übergehen (Art. 14 Abs. 4 lit. b, d)
Der Arbeit geber, der es einse t z t
- Hält die Eingabedaten, die er steuert, relevant und hinreichend repräsentativ (Art. 26 Abs. 4)
- Erklärt Betroffenen auf Verlangen die Rolle der KI und die wesentlichen Elemente der Entscheidung (Art. 86)
- Kann selbst Anbieter werden, wenn er allgemeine KI zur Sichtung von Lebensläufen umwidmet (Art. 25 Abs. 1 lit. c)
Die letzte Zeile zählt vor allem für kleine Firmen: Ein allgemeiner Chatbot, der Bewerbungen sortieren soll, dient einem hochriskanten Zweck, für den er nicht in Verkehr gebracht wurde. Artikel 25 gibt der Firma, die das tut, dann die Pflichten des Anbieters nach Artikel 16.
Unsere Lesar t
„Ein Mensch prüft das“ ist keine Aufsicht, wenn dieser Mensch nur die Auswahlliste sieht. Aufsicht beginnt bei den Abgelehnten.
Verordnung (EU) 2024/1689, Artikel 10, 13, 14, 16, 25, 26 und 86 und Anhang III; Datum nach Artikel 113 in der Fassung der Verordnung (EU) 2026/1744, die die hier zitierten Bestimmungen unverändert ließ. Formulierung und Lesehinweis: Redaktion; keine Rechtsberatung. Fristen, weitere Arbeitgeberpflichten und Art. 6 Abs. 3 in Nr. 41. Der Essay: die Sicht des Autors, wer entscheidet, wenn ein System zuerst entscheidet.
Quellen: European Parliament and Council of the European Union, Official Journal of the EU, 2024; European Parliament and Council of the European Union, Official Journal of the EU, 2026
Mehr im Essay: Das System ist schneller als Sie
Was die Forschung sagt
Ein Ergebnis, das sich umkehr te
Der Haupttest nutzte weiße Namen, die in Texten etwa 5,5-mal so häufig vorkommen wie die Schwarzen, passend zur Bevölkerung. In einem zweiten Durchlauf waren die weißen Namen etwa so häufig wie die Schwarzen. Sonst änderte sich nichts.
Anteil der 27 Herkunftstests, den jede Gruppe gewann, nach Wahl der Namen (2024): Weiß konnotierte Namen: Namen nach Anteil 85,1 %, Namen gleich häufig 22,2 %; Schwarz konnotierte Namen: Namen nach Anteil 8,6 %, Namen gleich häufig 51,9 %.
Im August 2026 ergänzten die Forschenden eine Korrektur: Nachdem ein Team der Universität Salzburg die Studie zu wiederholen versucht hatte, fand sich ein Programmfehler, der in den reinen Geschlechtertests die Bezeichnungen vertauscht hatte. Frauennamen, nicht Männernamen, wurden in 51,9 % dieser Tests bevorzugt. Die Ergebnisse zu Herkunft und Überschneidungen blieben bestehen.
Unsere Lesar t
Ein einzelnes Audit ist eine Messung, kein Urteil. Fragen Sie, wie der Test gebaut war und ob ihn jemand wiederholt hat.
Wilson & Caliskan (2024), arXiv-Version 3 (30. August 2026) mit dem Korrekturhinweis; Abschnitt zu Häufigkeitseffekten. Die Forschenden deuten die Umkehr als Empfindlichkeit der Modelle für die Häufigkeit eines Namens. Der Lesehinweis stammt von der Redaktion.
Quelle: Kyra Wilson & Aylin Caliskan, Proceedings of the AAAI/ACM Conference on AI, Ethics, and Society 7, 2024
Wie es gemessen wird
Das eigene System testen
Die Methode der Studie lässt sich in einen Test für ein bereits genutztes System verwandeln: identische Lebensläufe, die sich in einem Signal unterscheiden, durch denselben Schritt geschickt, die Auswahlquoten verglichen. Die Schritte unten sind ein Vorschlag der Redaktion, nicht der Studie.
- Echte Anzeigen, erfundene Lebensläufe. Keine Daten echter Bewerber; mehrere Berufe.
- Nur ein Signal ändern. Ein Name, ein Frauenverein, eine Schule, ein Alter; und Kombinationen.
- Die echte Grenze behalten. Den Anteil, den wirklich ein Mensch liest, etwa die besten 10 %.
- Auswahlquoten vergleichen. Je Gruppe und Kombination; dann Länge und Wortwahl variieren.
- Melden. Protokoll aufbewahren; den Anbieter über Risiken informieren (Art. 26 Abs. 5).
Unsere Lesar t
Ein System, das nie mit getauschtem Namen getestet wurde, hat keine bekannte Verzerrung, was nicht dasselbe ist wie keine.
Vorschlag der Redaktion nach dem Vorbild von Wilson & Caliskan (2024), die auch die Länge der Lebensläufe änderten und damit die Ergebnisse veränderten. Seit Juli 2026 erlaubt Artikel 4a Arbeitgebern mit Hochrisiko-KI, sensible Daten zur Erkennung von Verzerrungen unter strengen Bedingungen zu verarbeiten; eine Pflicht dazu entsteht nicht. Das strukturierte Interview steht in Nr. 65.
Quellen: Kyra Wilson & Aylin Caliskan, Proceedings of the AAAI/ACM Conference on AI, Ethics, and Society 7, 2024; European Parliament and Council of the European Union, Official Journal of the EU, 2024; European Parliament and Council of the European Union, Official Journal of the EU, 2026
Werkzeug der Ausgabe
Eine Kar te für ein Sichtungssystem
Eine Karte für jedes System, das Bewerbungen vor einem Menschen liest. Das Werkzeug ATS CV zeigt die andere Seite: wie Bewerbungssoftware einen Lebenslauf liest und was Bewerber tun können, damit er richtig gelesen wird.
- System und Zweckbestimmung für Recruiting gebaut oder ein allgemeines Werkzeug, das wir umgewidmet haben?
- Was es im Ablauf tut Anzeigen steuern, filtern, reihen oder bewerten; wo ein Mensch eingreift
- Wer die Abgelehnten sieht ein Name, wie viele geprüft werden, wer übergehen darf
- L
e t z ter Test mit ge tauschtem Namen Datum, Signale und Kombinationen, Ergebnis, an den Anbieter - Unsere Eingabedaten Anzeigen und Kriterien, die wir eingeben: für die Stelle relevant?
- Bewerber informie
r t, Erklärung wo sie vom KI-Einsatz erfahren; wer Anfragen beantwortet
Die Karte ist ein Vorschlag der Redaktion, gestützt auf die Artikel 14, 25, 26 und 86 der KI-Verordnung und die Methode von Wilson & Caliskan (2024); sie ist kein geprüftes Instrument und keine Rechtsberatung. Pflichten des Arbeitgebers vor dem Einsatz, etwa die Information der Arbeitnehmervertretung, stehen in Nr. 41.
Quellen: European Parliament and Council of the European Union, Official Journal of the EU, 2024; Kyra Wilson & Aylin Caliskan, Proceedings of the AAAI/ACM Conference on AI, Ethics, and Society 7, 2024
Tool öffnen: ATS-Lebenslauf
Quellen und Methode
Jede Zahl hat eine Quelle.
Die Zahlen dieser Ausgabe stammen aus den folgenden Quellen. Das Jahr zeigt, wie aktuell jede ist.
- Kyra Wilson & Aylin Caliskan, Proceedings of the AAAI/ACM Conference on AI, Ethics, and Society 7, „Gender, Race, and Intersectional Bias in Resume Screening via Language Model Retrieval (arXiv version 3, with the authors' correction of 29 August 2026)“, 2024. https://arxiv.org/abs/2407.20371
- European Parliament and Council of the European Union, Official Journal of the EU, „Regulation (EU) 2024/1689 laying down harmonised rules on artificial intelligence (Artificial Intelligence Act)“, 2024. https://eur-lex.europa.eu/eli/reg/2024/1689/oj
- European Parliament and Council of the European Union, Official Journal of the EU, „Regulation (EU) 2026/1744 amending Regulations (EU) 2024/1689, (EU) 2018/1139 and (EU) 2023/1230 (Digital Omnibus on AI)“, 2026. https://eur-lex.europa.eu/eli/reg/2026/1744/oj
Redaktionelle Me thode
Jede Zahl wurde auf Jahr, Herausgeber und Bedeutung geprüft, am Volltext, wo er sich öffnen ließ. Eine nur in einer Zusammenfassung, einem Abstract oder Auszügen gelesene Quelle ist mit „über“ markiert. Eine Zahl, die sich im Gelesenen nicht bestätigen ließ, ist auf ihrer Seite so markiert oder fehlt. Die Deutung des Herausgebers ist als „Unsere Lesart“ markiert.
Herausgegeben von Stiven Janaqi, der sie verantwortet; „die Redaktion“ ist in dieser Publikation er. Texte, Übersetzungen, Layout und die Prüfung der Zahlen an ihren Quellen entstehen in Arbeitssitzungen mit Claude, einem KI-Modell von Anthropic. Wie diese Seite entsteht
Management Review · Monatsausgabe