Im M5-Wettbewerb 2020 prognostizierte der Sieger Walmarts Absätze um 22,4 % genauer als die exponentielle Glättung, doch nur 7,5 % der Teams schlugen diese Vergleichsmethode. In M4 wie in M5 gewannen Kombinationen; maschinelles Lernen gewann, wenn es über viele verwandte Reihen zugleich lernte. Für den Gesamtabsatz waren die Gewinne groß, für ein Produkt in einer Filiale klein. Einfache Vergleichsmethoden zeigen, ob eine Methode half, und vier Unternehmen zeigen, wann die Handkorrektur eines Planers half.
Management Review · Zweite Serie · November 2026 · Nr. 77
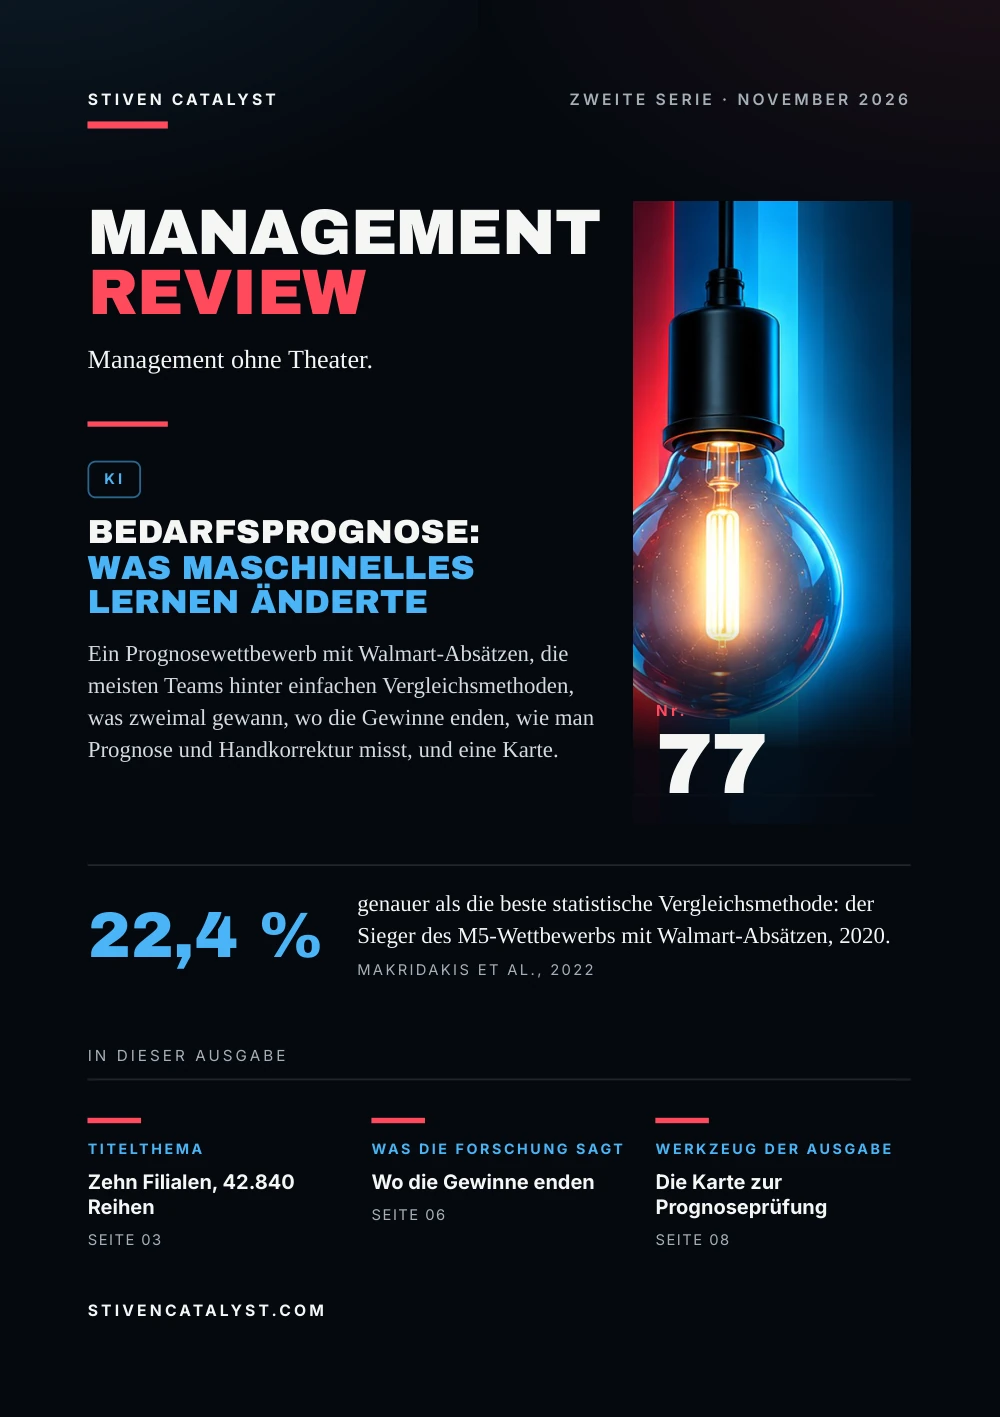
Bedarfsprognose: was maschinelles Lernen änder te
Ein Prognosewettbewerb mit Walmart-Absätzen, die meisten Teams hinter einfachen Vergleichsmethoden, was zweimal gewann, wo die Gewinne enden, wie man Prognose und Handkorrektur misst, und eine Karte.
- Nr.
- 77
- Seiten
- 10
- Quellen
- 6
- Themen
- KI
Stiven CatalystZweite Serie · November 2026
ManagementReview
Management ohne Theater.
KI
Bedarfsprognose:was maschinelles Lernen änderte
Ein Prognosewettbewerb mit Walmart-Absätzen, die meisten Teams hinter einfachen Vergleichsmethoden, was zweimal gewann, wo die Gewinne enden, wie man Prognose und Handkorrektur misst, und eine Karte.

Nr.77
22,4 %
genauer als die beste statistische Vergleichsmethode: der Sieger des M5-Wettbewerbs mit Walmart-Absätzen, 2020.Makridakis et al., 2022
stivencatalyst.com
Nr. 77 · KI
In dieser Ausgabe
Eine Bedarfsprognose entscheidet, was bestellt wird, wie viele Leute im Dienstplan stehen und wie viel Bestand im Regal wartet. Maschinelles Lernen verspricht bessere Prognosen. Diese Ausgabe fragt, was die größten offenen Prognosewettbewerbe dazu fanden, was es änderte und was nicht.
- 03TitelthemaZehn Filialen, 42.840 Reihen
- 04Die ZahlenDie meisten schlugen die einfachen nicht
- 05Das ModellWas gewann, zweimal
- 06Was die Forschung sagtWo die Gewinne enden
- 07Wie man es misstMessen gegen die naive Prognose
- 08Werkzeug der AusgabeDie Karte zur Prognoseprüfung
- 09QuellenQuellen und Methode
So lesen Sie diese Ausgabe
Zahl
Jede Zahl hat Quelle und Jahr unten auf ihrer Seite.
Unsere Lesart
Wo die Redaktion deutet und nicht die Forschung, steht es dabei.
Praxis
Schritte und Karte sind Vorschläge zum Ausprobieren, keine Forschungsergebnisse.
Titelthema
Zehn Filialen,42.840 Reihen
2020 gab der M5-Wettbewerb Prognostikern mehr als fünf Jahre tägliche Stückabsätze von Walmart: 3.049 Produkte in zehn Filialen in Kalifornien, Texas und Wisconsin. Aufgabe war, die nächsten 28 Tage vorherzusagen.
42.840Reihen auf 12 Ebenen: jedes Produkt je Filiale, summiert nach Abteilung, Kategorie, Filiale und Bundesstaat
30.490Prognosen auf der untersten Ebene, ein Produkt je Filiale; der Rest daraus summiert
Das Siegerteam war 22,4 % genauer als die beste statistische Vergleichsmethode, die exponentielle Glättung. Nur die ersten fünf kamen über 20 %, alle 50 besten über 14 %. Der Sieger mittelte gleich gewichtet viele LightGBM-Modelle, ein Verfahren aus Entscheidungsbäumen, jedes über alle Reihen einer Filiale, Filialkategorie oder Filialabteilung trainiert.
Unsere Lesart
Ein Teil des Gewinns kam von der Saisonmodellierung und äußeren Informationen wie Preisen; der Rest, meinen die Veranstalter, vom Lernen über Tausende verwandter Reihen zugleich.
Quellen: Spyros Makridakis et al., International Journal of Forecasting 38(4), The M5 competition: Background, organization, and implementation, 2022 (über Abstract; the intermittency shares from a later paper); Spyros Makridakis et al., International Journal of Forecasting 38(4), M5 accuracy competition: Results, findings, and conclusions, 2022 (über The authors' preprint, 2020)
Genauigkeit als WRMSSE: Fehler jeder Reihe skaliert am Fehler einer naiven Prognose und gewichtet nach ihrem Umsatz in Dollar. Die Ergebnisarbeit lag als Vorabfassung der Autoren (2020) vor, die Arbeit zu den Daten nur als Abstract.
Die Zahlen
Die meisten schlugendie einfachen nicht
Neben den Einsendungen ließen die Veranstalter Vergleichsmethoden laufen, von der naiven Prognose, die den letzten Wert wiederholt, bis zur exponentiellen Glättung. Von den Teams der Schlusswertung schlug jede davon dieser Anteil:
Teams, die jede Vergleichsmethode schlugen, M5, 2020
Hätte jedes Team seinen besten Versuch eingereicht, hätten 63,7 %, 48,8 % und 12,2 % sie geschlagen. Die Veranstalter vermuten irreführende Validierungswerte: Viele Teams wählten nicht die beste Methode, die sie gebaut hatten.
Unsere Lesart
Ein komplexes Modell ist leicht gebaut und schwer geprüft. Ohne einfache Vergleichsmethode daneben weiß niemand, ob es half.
Quelle: Spyros Makridakis et al., International Journal of Forecasting 38(4), 2022 (über The authors' preprint, 2020)
Endgültige Einsendungen. Die Veranstalter fügen an, dass viele Teams hinter der exponentiellen Glättung das Interesse verloren haben könnten; die 7,5 % sind daher womöglich etwas verzerrt.
Das Modell
Was gewann,zweimal
Zwei Jahre vor M5 verlangte der M4-Wettbewerb Prognosen für 100.000 Zeitreihen. Seine Lehren und die von M5 weisen in dieselbe Richtung, mit einer Änderung.
M4, 2018
- 12 der 17 genauesten Methoden waren Kombinationen
- der Sieger, ein Hybrid aus Statistik und neuronalem Netz, rund 10 % besser als eine Vergleichskombination
- sechs reine Methoden des maschinellen Lernens: keine schlug die Kombination, eine die naive
M5, 2020
- LightGBM in den meisten Spitzenbeiträgen
- Kombinationen vieler Modelle
- ein Modell, das über viele Reihen lernt
- Preise, Aktionen und Ereignisse als Eingaben
Unsere Lesart
Maschinelles Lernen gewann, wo es viele verwandte Reihen und Informationen über die Absatzhistorie hinaus gab, wie in M5. Reines maschinelles Lernen in M4 hatte nicht gewonnen.
Quellen: Spyros Makridakis et al., International Journal of Forecasting 34(4), 2018 (über Abstract in library records); Spyros Makridakis et al., International Journal of Forecasting 38(4), 2022 (über The authors' preprint, 2020)
Die 10 % in M4 beziehen sich auf sMAPE, einen prozentualen Fehler. In M5 war exponentielle Glättung mit Aktionen und Sondertagen 6 % genauer als ohne, ARIMA mit solchen Eingaben 13 %.
Was die Forschung sagt
Wo dieGewinne enden
Die 42.840 Reihen liegen auf 12 Ebenen, vom gesamten Walmart-Absatz in den Daten bis zu einem Produkt in einer Filiale. Die Veranstalter verglichen die besten Methoden auf jeder Ebene mit der besten Vergleichsmethode.
Durchschnittlicher Gewinn der besten Methoden gegenüber der besten Vergleichsmethode, nach Ebene (2020)
Für ein Produkt in einer Filiale waren 73 % der 30.490 Reihen sporadisch: Tage ohne Verkauf, dann ein paar. Dort, so die Veranstalter, hatten die üblichen Methoden für sporadischen Bedarf noch einen gewissen Wert.
Unsere Lesart
Die Prognose, die das Regal füllt, bleibt die unsichere. Bestand, Personal und Kapazität für den Fehler planen, nicht nur für die Zahl.
Quellen: Spyros Makridakis et al., International Journal of Forecasting 38(4), M5 accuracy competition: Results, findings, and conclusions, 2022 (über The authors' preprint, 2020); Spyros Makridakis et al., International Journal of Forecasting 38(4), The M5 competition: Background, organization, and implementation, 2022 (über Abstract; the intermittency shares from a later paper)
Gerundete Durchschnitte, gelesen in der Vorabfassung der Ergebnisarbeit. Auf den drei untersten Ebenen lag der Gesamtsieger unter den besten 50 auf Platz 11 bis 13.
Mehr im EssayTage mit hohem Volumen: der Standard unter Druck
Wie man es misst
Messen gegendie naive Prognose
Rob Hyndman und George Athanasopoulos nutzen im ganzen Lehrbuch vier einfache Methoden als Vergleich; die einfachste, die naive Prognose, wiederholt den letzten Wert. Andere Methoden werden mit ihnen verglichen.
Drei Fehlermaße
MAE, mittlerer absoluter Fehler
In Stück. Ihn zu minimieren führt zum Median, RMSE zu minimieren zum Mittelwert.
MAPE, mittlerer absoluter prozentualer Fehler
Unendlich oder undefiniert an einem Tag ohne Absatz, extrem nahe null.
MASE, mittlerer absoluter skalierter Fehler
Unter 1, wenn die Prognose die naive auf vergangenen Daten schlägt.
In vier Unternehmen der Lieferkette, bei über 60.000 Prognosen, änderten Planer im Schnitt 75 % der Systemprognosen. Große Korrekturen halfen mehr, kleine schadeten oft. Korrekturen nach oben halfen viel seltener und gingen öfter in die falsche Richtung.
Unsere Lesart
Jede Hand an der Prognose messen: das System gegen die naive, die Korrektur gegen das System.
Quellen: Rob J. Hyndman & George Athanasopoulos, OTexts, 2021; Robert Fildes et al., International Journal of Forecasting 25(1), 2009 (über Abstract and summaries); Robert Fildes & Paul Goodwin, Foresight 8, 2007
Maße wie bei Hyndman & Athanasopoulos (2021). Fildes et al.: drei Hersteller mit Monats-, ein Händler mit Wochenprognosen; die Autoren sehen im Hang nach oben Optimismus.
Werkzeug der Ausgabe
Die Kar te zurPrognoseprüfung
Eine Karte pro Produktfamilie und Monat: die naive Prognose neben der des Systems, jede Handkorrektur mit Grund, und ob der Fehler zu einer Seite neigt.
01Reihe und EbeneProduktfamilie, Filiale oder Region; wie viele Tage ohne Absatz
02Vergleichnaiv oder saisonal naiv: sein Fehler im selben Zeitraum
03SystemprognoseFehler in Stück (MAE) und gegen den Vergleich (MASE)
04Handkorrekturenwer was änderte, nach oben oder unten, um wie viel, und warum
05Wert der KorrekturFehler nach der Korrektur gegen die Systemprognose davor
06FehlerneigungMonate über gegen unter dem Absatz; die Fehler in einer Regelkarte
07Nächster Monatbehalten, Methode oder Daten ändern, nutzlose Korrekturen lassen
Quellen: Rob J. Hyndman & George Athanasopoulos, OTexts, 2021; Robert Fildes et al., International Journal of Forecasting 25(1), 2009 (über Abstract and summaries)
Eine Praxis, die die Redaktion vorschlägt, nach Hyndman & Athanasopoulos (2021) und Fildes et al. (2009). Zum Monatsplan selbst siehe Nr. 59.
Tool öffnen: Sigma & Regelkartestivencatalyst.com/de/tools/sigma-control-chart/
Quellen und Methode
Jede Zahlhat eine Quelle.
Die Zahlen dieser Ausgabe stammen aus den folgenden Quellen. Das Jahr zeigt, wie aktuell jede ist.
- M5 accuracy competition: Results, findings, and conclusionsSpyros Makridakis et al., International Journal of Forecasting 38(4), 2022 · über The authors' preprint, 2020https://doi.org/10.1016/j.ijforecast.2021.11.013
- The M5 competition: Background, organization, and implementationSpyros Makridakis et al., International Journal of Forecasting 38(4), 2022 · über Abstract; the intermittency shares from a later paperhttps://www.sciencedirect.com/science/article/pii/S0169207021001187
- The M4 Competition: Results, findings, conclusion and way forwardSpyros Makridakis et al., International Journal of Forecasting 34(4), 2018 · über Abstract in library recordshttps://doi.org/10.1016/j.ijforecast.2018.06.001
- Forecasting: Principles and Practice, 3rd editionRob J. Hyndman & George Athanasopoulos, OTexts, 2021https://otexts.com/fpp3/
- Effective forecasting and judgmental adjustments: an empirical evaluation and strategies for improvement in supply-chain planningRobert Fildes et al., International Journal of Forecasting 25(1), 2009 · über Abstract and summarieshttps://doi.org/10.1016/j.ijforecast.2008.11.010
- Good and Bad Judgment in Forecasting: Lessons from Four CompaniesRobert Fildes & Paul Goodwin, Foresight 8, 2007https://forecasters.org/wp-content/uploads/Good-and-Bad-Judgment-in-Forecasting_Issue8.pdf
Redaktionelle Methode
Jede Zahl wurde auf Jahr, Herausgeber und genaue Bedeutung geprüft. Wo die Seite des Herausgebers nicht erreichbar war, wurde sie an unabhängigen Zusammenfassungen geprüft und mit „über“ markiert. Die Deutung der Redaktion ist als „Unsere Lesart“ markiert. Zahlen, die sich nicht bestätigen ließen, stehen nicht in der Ausgabe.
ManagementReview
Management ohne Theater.
Jede Ausgabe eine Führungsfrage, geprüft an der besten Forschung.
Alle Ausgaben
stivencatalyst.com/de/magazine/management-review.html
Management Review · Nr. 77 · November 2026 · Stiven Catalyst
Zum Umblättern auf eine Seite klicken oder wischen. Die Pfeiltasten gehen auch.
Management Review · Nr. 77
Die Zahlen der Ausgabe
Die Grafiken der gedruckten Seiten, mit ihren Quellen.
Quelle: Spyros Makridakis et al., International Journal of Forecasting 38(4), 2022 (über The authors' preprint, 2020)
Quelle: Spyros Makridakis et al., International Journal of Forecasting 38(4), 2022 (über The authors' preprint, 2020)
Der ganze Text Die Ausgabe als Text lesen Zum Lesen auf kleinen Bildschirmen, zum Suchen oder mit Screenreader. Dieselben Worte, ohne die Seitengestaltung.
In dieser Ausgabe
Eine Bedarfsprognose entscheidet, was bestellt wird, wie viele Leute im Dienstplan stehen und wie viel Bestand im Regal wartet. Maschinelles Lernen verspricht bessere Prognosen. Diese Ausgabe fragt, was die größten offenen Prognosewettbewerbe dazu fanden, was es änderte und was nicht.
Im M5-Wettbewerb 2020 prognostizierte der Sieger Walmarts Absätze um 22,4 % genauer als die exponentielle Glättung, doch nur 7,5 % der Teams schlugen diese Vergleichsmethode. In M4 wie in M5 gewannen Kombinationen; maschinelles Lernen gewann, wenn es über viele verwandte Reihen zugleich lernte. Für den Gesamtabsatz waren die Gewinne groß, für ein Produkt in einer Filiale klein. Einfache Vergleichsmethoden zeigen, ob eine Methode half, und vier Unternehmen zeigen, wann die Handkorrektur eines Planers half.
Stiven Janaqi, Herausgeber
Titelthema
Zehn Filialen, 42.840 Reihen
2020 gab der M5-Wettbewerb Prognostikern mehr als fünf Jahre tägliche Stückabsätze von Walmart: 3.049 Produkte in zehn Filialen in Kalifornien, Texas und Wisconsin. Aufgabe war, die nächsten 28 Tage vorherzusagen.
- 42.840 Reihen auf 12 Ebenen: jedes Produkt je Filiale, summiert nach Abteilung, Kategorie, Filiale und Bundesstaat
- 30.490 Prognosen auf der untersten Ebene, ein Produkt je Filiale; der Rest daraus summiert
Das Siegerteam war 22,4 % genauer als die beste statistische Vergleichsmethode, die exponentielle Glättung. Nur die ersten fünf kamen über 20 %, alle 50 besten über 14 %. Der Sieger mittelte gleich gewichtet viele LightGBM-Modelle, ein Verfahren aus Entscheidungsbäumen, jedes über alle Reihen einer Filiale, Filialkategorie oder Filialabteilung trainiert.
Unsere Lesar t
Ein Teil des Gewinns kam von der Saisonmodellierung und äußeren Informationen wie Preisen; der Rest, meinen die Veranstalter, vom Lernen über Tausende verwandter Reihen zugleich.
Genauigkeit als WRMSSE: Fehler jeder Reihe skaliert am Fehler einer naiven Prognose und gewichtet nach ihrem Umsatz in Dollar. Die Ergebnisarbeit lag als Vorabfassung der Autoren (2020) vor, die Arbeit zu den Daten nur als Abstract.
Quellen: Spyros Makridakis et al., International Journal of Forecasting 38(4), The M5 competition: Background, organization, and implementation, 2022 (über Abstract; the intermittency shares from a later paper); Spyros Makridakis et al., International Journal of Forecasting 38(4), M5 accuracy competition: Results, findings, and conclusions, 2022 (über The authors' preprint, 2020)
Die Zahlen
Die meisten schlugen die einfachen nicht
Neben den Einsendungen ließen die Veranstalter Vergleichsmethoden laufen, von der naiven Prognose, die den letzten Wert wiederholt, bis zur exponentiellen Glättung. Von den Teams der Schlusswertung schlug jede davon dieser Anteil:
Teams, die jede Vergleichsmethode schlugen, M5, 2020: Naive Prognose 48,4 %, Saisonal naive Prognose 35,8 %, Exponentielle Glättung, die beste Methode 7,5 %.
Hätte jedes Team seinen besten Versuch eingereicht, hätten 63,7 %, 48,8 % und 12,2 % sie geschlagen. Die Veranstalter vermuten irreführende Validierungswerte: Viele Teams wählten nicht die beste Methode, die sie gebaut hatten.
Unsere Lesar t
Ein komplexes Modell ist leicht gebaut und schwer geprüft. Ohne einfache Vergleichsmethode daneben weiß niemand, ob es half.
Endgültige Einsendungen. Die Veranstalter fügen an, dass viele Teams hinter der exponentiellen Glättung das Interesse verloren haben könnten; die 7,5 % sind daher womöglich etwas verzerrt.
Quelle: Spyros Makridakis et al., International Journal of Forecasting 38(4), 2022 (über The authors' preprint, 2020)
Das Modell
Was gewann, zweimal
Zwei Jahre vor M5 verlangte der M4-Wettbewerb Prognosen für 100.000 Zeitreihen. Seine Lehren und die von M5 weisen in dieselbe Richtung, mit einer Änderung.
M4, 2018
- 12 der 17 genauesten Methoden waren Kombinationen
- der Sieger, ein Hybrid aus Statistik und neuronalem Netz, rund 10 % besser als eine Vergleichskombination
- sechs reine Methoden des maschinellen Lernens: keine schlug die Kombination, eine die naive
M5, 2020
- LightGBM in den meisten Spitzenbeiträgen
- Kombinationen vieler Modelle
- ein Modell, das über viele Reihen lernt
- Preise, Aktionen und Ereignisse als Eingaben
Unsere Lesar t
Maschinelles Lernen gewann, wo es viele verwandte Reihen und Informationen über die Absatzhistorie hinaus gab, wie in M5. Reines maschinelles Lernen in M4 hatte nicht gewonnen.
Die 10 % in M4 beziehen sich auf sMAPE, einen prozentualen Fehler. In M5 war exponentielle Glättung mit Aktionen und Sondertagen 6 % genauer als ohne, ARIMA mit solchen Eingaben 13 %.
Quellen: Spyros Makridakis et al., International Journal of Forecasting 34(4), 2018 (über Abstract in library records); Spyros Makridakis et al., International Journal of Forecasting 38(4), 2022 (über The authors' preprint, 2020)
Was die Forschung sagt
Wo die Gewinne enden
Die 42.840 Reihen liegen auf 12 Ebenen, vom gesamten Walmart-Absatz in den Daten bis zu einem Produkt in einer Filiale. Die Veranstalter verglichen die besten Methoden auf jeder Ebene mit der besten Vergleichsmethode.
Durchschnittlicher Gewinn der besten Methoden gegenüber der besten Vergleichsmethode, nach Ebene (2020): Gesamt (1) ~40 %, Ebenen 5–7 ~23 %, Produkt, Filiale (10–12) ~3 %.
Für ein Produkt in einer Filiale waren 73 % der 30.490 Reihen sporadisch: Tage ohne Verkauf, dann ein paar. Dort, so die Veranstalter, hatten die üblichen Methoden für sporadischen Bedarf noch einen gewissen Wert.
Unsere Lesar t
Die Prognose, die das Regal füllt, bleibt die unsichere. Bestand, Personal und Kapazität für den Fehler planen, nicht nur für die Zahl.
Gerundete Durchschnitte, gelesen in der Vorabfassung der Ergebnisarbeit. Auf den drei untersten Ebenen lag der Gesamtsieger unter den besten 50 auf Platz 11 bis 13.
Quellen: Spyros Makridakis et al., International Journal of Forecasting 38(4), M5 accuracy competition: Results, findings, and conclusions, 2022 (über The authors' preprint, 2020); Spyros Makridakis et al., International Journal of Forecasting 38(4), The M5 competition: Background, organization, and implementation, 2022 (über Abstract; the intermittency shares from a later paper)
Mehr im Essay: Tage mit hohem Volumen: der Standard unter Druck
Wie man es misst
Messen gegen die naive Prognose
Rob Hyndman und George Athanasopoulos nutzen im ganzen Lehrbuch vier einfache Methoden als Vergleich; die einfachste, die naive Prognose, wiederholt den letzten Wert. Andere Methoden werden mit ihnen verglichen.
Drei Fehlermaße
- MAE, mi
t tlerer absoluter Fehler. In Stück. Ihn zu minimieren führt zum Median, RMSE zu minimieren zum Mittelwert. - MAPE, mi
t tlerer absoluter prozentualer Fehler. Unendlich oder undefiniert an einem Tag ohne Absatz, extrem nahe null. - MASE, mi
t tlerer absoluter skalier ter Fehler. Unter 1, wenn die Prognose die naive auf vergangenen Daten schlägt.
In vier Unternehmen der Lieferkette, bei über 60.000 Prognosen, änderten Planer im Schnitt 75 % der Systemprognosen. Große Korrekturen halfen mehr, kleine schadeten oft. Korrekturen nach oben halfen viel seltener und gingen öfter in die falsche Richtung.
Unsere Lesar t
Jede Hand an der Prognose messen: das System gegen die naive, die Korrektur gegen das System.
Maße wie bei Hyndman & Athanasopoulos (2021). Fildes et al.: drei Hersteller mit Monats-, ein Händler mit Wochenprognosen; die Autoren sehen im Hang nach oben Optimismus.
Quellen: Rob J. Hyndman & George Athanasopoulos, OTexts, 2021; Robert Fildes et al., International Journal of Forecasting 25(1), 2009 (über Abstract and summaries); Robert Fildes & Paul Goodwin, Foresight 8, 2007
Werkzeug der Ausgabe
Die Kar te zur Prognoseprüfung
Eine Karte pro Produktfamilie und Monat: die naive Prognose neben der des Systems, jede Handkorrektur mit Grund, und ob der Fehler zu einer Seite neigt.
- Reihe und Ebene Produktfamilie, Filiale oder Region; wie viele Tage ohne Absatz
- Vergleich naiv oder saisonal naiv: sein Fehler im selben Zeitraum
- Systemprognose Fehler in Stück (MAE) und gegen den Vergleich (MASE)
- Handkorrekturen wer was änderte, nach oben oder unten, um wie viel, und warum
- We
r t der Korrektur Fehler nach der Korrektur gegen die Systemprognose davor - Fehlerneigung Monate über gegen unter dem Absatz; die Fehler in einer Regelkarte
- Nächster Monat behalten, Methode oder Daten ändern, nutzlose Korrekturen lassen
Eine Praxis, die die Redaktion vorschlägt, nach Hyndman & Athanasopoulos (2021) und Fildes et al. (2009). Zum Monatsplan selbst siehe Nr. 59.
Quellen: Rob J. Hyndman & George Athanasopoulos, OTexts, 2021; Robert Fildes et al., International Journal of Forecasting 25(1), 2009 (über Abstract and summaries)
Tool öffnen: Sigma & Regelkarte
Quellen und Methode
Jede Zahl hat eine Quelle.
Die Zahlen dieser Ausgabe stammen aus den folgenden Quellen. Das Jahr zeigt, wie aktuell jede ist.
- Spyros Makridakis et al., International Journal of Forecasting 38(4), “M5 accuracy competition: Results, findings, and conclusions”, 2022 (über The authors' preprint, 2020). https://doi.org/10.1016/j.ijforecast.2021.11.013
- Spyros Makridakis et al., International Journal of Forecasting 38(4), “The M5 competition: Background, organization, and implementation”, 2022 (über Abstract; the intermittency shares from a later paper). https://www.sciencedirect.com/science/article/pii/S0169207021001187
- Spyros Makridakis et al., International Journal of Forecasting 34(4), “The M4 Competition: Results, findings, conclusion and way forward”, 2018 (über Abstract in library records). https://doi.org/10.1016/j.ijforecast.2018.06.001
- Rob J. Hyndman & George Athanasopoulos, OTexts, “Forecasting: Principles and Practice, 3rd edition”, 2021. https://otexts.com/fpp3/
- Robert Fildes et al., International Journal of Forecasting 25(1), “Effective forecasting and judgmental adjustments: an empirical evaluation and strategies for improvement in supply-chain planning”, 2009 (über Abstract and summaries). https://doi.org/10.1016/j.ijforecast.2008.11.010
- Robert Fildes & Paul Goodwin, Foresight 8, “Good and Bad Judgment in Forecasting: Lessons from Four Companies”, 2007. https://forecasters.org/wp-content/uploads/Good-and-Bad-Judgment-in-Forecasting_Issue8.pdf
Redaktionelle Me thode
Jede Zahl wurde auf Jahr, Herausgeber und genaue Bedeutung geprüft. Wo die Seite des Herausgebers nicht erreichbar war, wurde sie an unabhängigen Zusammenfassungen geprüft und mit „über“ markiert. Die Deutung der Redaktion ist als „Unsere Lesart“ markiert. Zahlen, die sich nicht bestätigen ließen, stehen nicht in der Ausgabe.
Management Review · Monatsausgabe